NT-2026.08.25 DOSSIÊ PENTEST
INTELIGÊNCIA ARTIFICIAL (IA) EM CIBERSEGURANÇA
Como agentes de IA como o PentestCode organizam recon, exploração e reporting em pentest real — arquitetura, autonomia e limites do humano no loop.
Pedir a um LLM para sugerir um comando de enumeração SMB e copiar a resposta para o terminal não é automação — é apenas uma consulta. O que muda a natureza do trabalho é um sistema capaz de manter o estado de um engagement inteiro: quais hosts já foram descobertos, quais credenciais foram validadas, o que já falhou, o que ainda precisa de confirmação — e usar esse estado para decidir a próxima ação sozinho, dentro de um escopo definido.
É essa diferença — entre responder perguntas e coordenar um processo com memória e decisão progressiva — que separa um chatbot de segurança de um agente operacional. O PentestCode, projeto open source (MIT) mantido por s0ld13rr no GitHub, é um dos exemplos mais completos dessa categoria hoje, e serve de estudo de caso técnico para esta análise.
O aspecto mais relevante do PentestCode não é simplesmente o uso de um LLM, mas a tentativa de transformar modelos de IA em agentes capazes de manter contexto de um engagement, coordenar tarefas, interpretar ferramentas de segurança e tomar decisões progressivas dentro de um escopo definido.
Vale adiantar o contraponto que sustenta todo o restante deste artigo: um agente desse tipo não “faz mágica”. Ele continua dependendo de ferramentas reais, dados reais, permissões configuradas, qualidade do modelo escolhido, contexto, metodologia, regras de escopo e, sobretudo, validação humana.
O que é o PentestCode
Segundo o repositório oficial, o PentestCode é um hard fork do OpenCode — projeto MIT originalmente focado em edição de código — removido de seu foco original e reconstruído para operações de segurança ofensiva pelo terminal. O projeto está em estado beta (a própria documentação descreve que “se sustenta em engagements reais e CTFs, mas espere arestas”), com centenas de estrelas e mais de cem commits no momento desta pesquisa.
Documentação oficial confirma um conjunto extenso de capacidades: arquitetura multi-agent com um coordenador e agentes especializados, estado persistente de engagement, memória compartilhada entre agentes, rastreamento de targets descobertos versus autorizados, findings com score de confiança, cálculo de attack paths, coordenação paralela de tarefas, parsers dedicados para interpretar saída de ferramentas conhecidas, mecanismos de pausa/checkpoint e geração de relatórios. Cada um desses pontos é detalhado nas seções seguintes — nenhum deles é atribuído aqui sem confirmação na fonte oficial.
De chatbot para agente de pentest
A diferença entre os dois modelos fica clara lado a lado. Em um chat tradicional, o operador pergunta algo como “Como enumerar serviços SMB nesse host?” — o modelo responde com sugestões de comando, mas não conhece o estado completo do engagement e não executa a cadeia por conta própria. Cada pergunta é, na prática, isolada da anterior, a menos que o próprio operador reintroduza o contexto manualmente.
No agentic pentesting, o fluxo conceitual passa a ser cíclico:
Objetivo
   ↓
Recon
   ↓
Coleta de evidências
   ↓
Interpretação
   ↓
Atualização do estado
   ↓
Seleção da próxima ação
   ↓
Execução da ferramenta
   ↓
Novo resultado
   ↓
Nova decisão
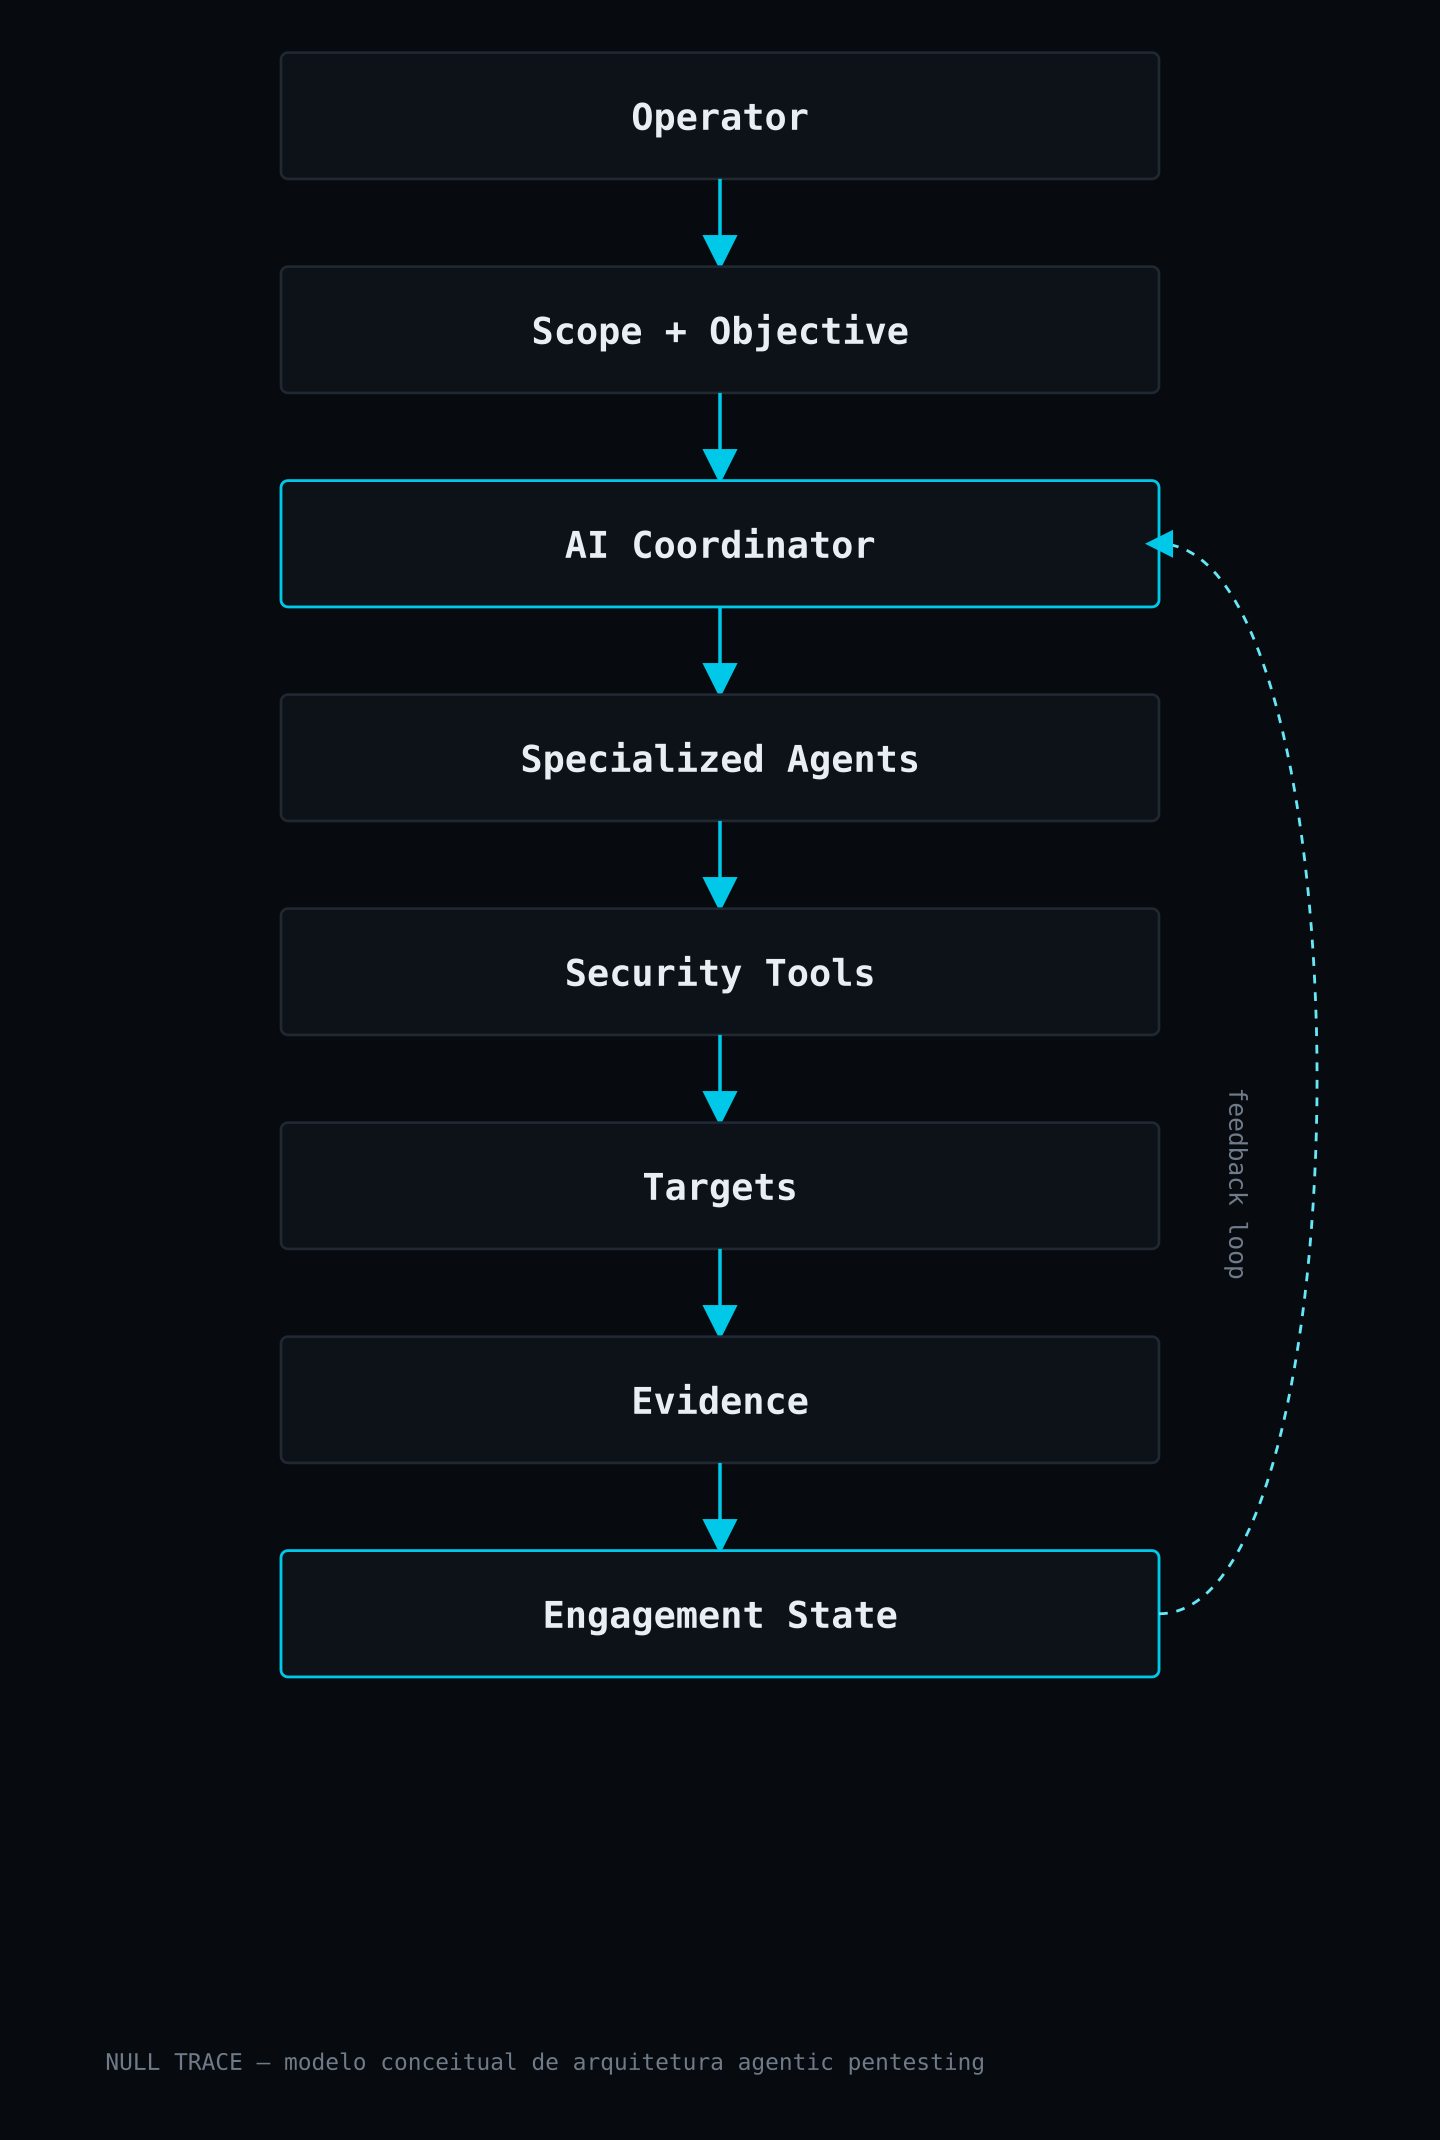
Esse diagrama é um modelo conceitual do que caracteriza a abordagem agentic de forma geral — não uma representação literal do código interno do PentestCode. A mudança real está no feedback loop operacional: cada resultado de ferramenta atualiza um estado persistente, e é esse estado — não apenas o prompt mais recente — que orienta a próxima decisão.
Como funciona a arquitetura multi-agent
Coordinator e subagentes
O PentestCode documenta oficialmente um modelo strategist-coordinator com agentes especialistas distribuídos. O agente coordenador (pentest) planeja tarefas e despacha especialistas em paralelo. Ao todo, a documentação lista 13 agentes especializados: recon, scanner, enumerator, exploiter, identity (voltado a Active Directory/Kerberos), infrastructure (SNMP/IPMI/bancos de dados), webapp (OWASP Top 10), post-exploit, exploit-dev, critic (validação de falsos positivos), reporter, além de dois agentes ocultos dedicados a compressão de contexto e gerenciamento de sessão.
O README do projeto cita explicitamente o modelo strategist-coordinator da pesquisa HPTSA (Hierarchical Planning and Task-Specific Agents), afirmando um ganho de 4,3× sobre abordagens single-agent. Validamos essa citação na fonte primária: o número vem do paper “Teams of LLM Agents can Exploit Zero-Day Vulnerabilities” (Zhu et al., 2024), que define HPTSA como “um sistema de agentes com um agente de planejamento capaz de lançar subagentes” e reporta a melhoria de até 4,3× sobre frameworks anteriores em um benchmark de 14 vulnerabilidades reais. Vale registrar: o link para o paper no README oficial do PentestCode aponta para um arXiv ID incorreto — o número em si é real e verificável, mas a citação precisa ser conferida na fonte correta, listada nas referências ao final.
Vantagens documentadas dessa divisão: paralelização de tarefas, especialização por domínio (um agente de AD não precisa carregar contexto de SQLi) e redução do contexto que cada agente individual precisa processar. Os problemas são igualmente reais e não específicos do PentestCode — qualquer arquitetura multi-agent enfrenta risco de inconsistência entre agentes, duplicação de tarefas, custo crescente de tokens com múltiplos agentes ativos, alucinação individual se propagando para o estado compartilhado, e decisões tomadas a partir de parsing incorreto de uma ferramenta. Nenhum desses riscos é eliminado pela arquitetura — apenas reorganizado, e é por isso que validação continua sendo indispensável.
Engagement State
Todos os agentes leem e escrevem em um estado estruturado compartilhado. Conceitualmente, esse estado se organiza assim:
Engagement
├── Scope
│   ├── Targets autorizados
│   └── Targets descobertos
├── Hosts
│   ├── Serviços
│   ├── Credenciais
│   └── Acessos
├── Findings
├── Attack Paths
├── Tentativas executadas
├── Objetivo atual
└── Evidências
Essa estrutura é uma simplificação didática — não uma correspondência exata aos objetos internos do código, que a documentação descreve de forma mais granular (hosts com IP/hostname/SO/portas/versões, vulnerabilidades com severidade/status/evidência/score de confiança, credenciais com mapeamento de qual serviço cada uma destrava, um grafo de relacionamentos entre entidades, um modelo dedicado de Active Directory e cálculo de rotas de ataque via Dijkstra com custo). O ponto central, porém, é o mesmo em qualquer nível de detalhe: o estado persiste entre sessões, e um log legível registra cada achado com timestamp.
Memória e evidências
A importância prática da memória fica clara quando se pensa no que ela evita: sem registro do que já foi testado, um agente tende a repetir a mesma enumeração, a mesma tentativa de exploração já descartada, ou a perder de vista de onde uma credencial específica veio. Registrar explicitamente o que falhou, o que teve evidência, o que ainda precisa de validação, de onde uma informação surgiu, quais hosts fazem parte do escopo e quais foram apenas descobertos é o que permite que decisões subsequentes sejam progressivas em vez de circulares — reduzindo loops e ações redundantes.
Instalando o PentestCode com segurança
A documentação oficial atual apresenta múltiplos métodos de instalação. Via npm:
npm install -g pentestcode-aiVia script de instalação (binário autocontido para Linux/macOS, x64/arm64):
curl -fsSL https://raw.githubusercontent.com/s0ld13rr/pentestcode/main/install.sh | bashO padrão curl | bash baixa e executa um shell script diretamente do GitHub — isso implica confiar integralmente no conteúdo remoto no momento da execução. Em ambientes corporativos ou qualquer contexto sensível, a prática apropriada é inspecionar o script antes de rodá-lo:
curl -fsSL https://raw.githubusercontent.com/s0ld13rr/pentestcode/main/install.sh -o install.sh
less install.sh
É possível também fixar uma versão específica via variável de ambiente, o que reduz a superfície de mudança inesperada entre uma revisão do script e a execução real:
PENTESTCODE_VERSION=0.1.7 curl -fsSL https://raw.githubusercontent.com/s0ld13rr/pentestcode/main/install.sh | bashExiste ainda um terceiro método, útil em ambiente sem npm/curl disponível ou quando se prefere baixar o binário já compilado de uma release específica direto da página de releases do repositório:
wget https://github.com/s0ld13rr/pentestcode/releases/download/v0.2.5/pentestcode-linux-x64.tar.gz
tar -xzf pentestcode-linux-x64.tar.gz
./pentestcode
Independentemente do método escolhido, vale um cuidado adicional de cadeia de suprimentos: baixe sempre do repositório oficial s0ld13rr/pentestcode, nunca de um fork. Já foram reportados forks distribuindo binários adulterados sob o mesmo nome de projeto — confira a organização/usuário antes de rodar qualquer coisa.
Não foi possível confirmar hashes de release específicos sem consultar a página de releases no momento da instalação — não presuma esse dado; verifique-o diretamente antes de instalar.
Providers, modelos e privacidade
O PentestCode integra mais de 20 providers de LLM via ai-sdk, incluindo Anthropic, OpenAI, Google, Azure, AWS Bedrock, Ollama, Together, Groq, Fireworks, DeepSeek e Mistral, configuráveis via arquivo de configuração local.
Autenticação é obrigatória na versão atual — a documentação oficial exige explicitamente:
pentestcode auth loginIsso é uma distinção importante em relação a qualquer relato anedótico de terceiros sobre “não precisar configurar chave” em algum contexto específico: o comportamento documentado oficialmente hoje exige autenticação com o provider de LLM escolhido antes do uso. Generalizar a ausência de necessidade de chave sem essa confirmação seria impreciso.
Uma atualização vale registrar: testes práticos publicados por outros pesquisadores (Hackers-Arise, agosto de 2026) relatam que o binário sobe com um provider padrão pré-configurado (identificado como “OpenCode Zen”, modelo “Big Pickle”) que funciona sem exigir chave própria do operador, sujeito a um limite diário de uso que se renova em algumas horas. Isso não contradiz a exigência de auth login documentada oficialmente — ela vale para quando você conecta seu próprio provider (Anthropic, OpenAI etc.) via /connect. Para trocar de modelo dentro do provider ativo, o comando é /models.
A escolha entre modelo local (via Ollama) e API externa envolve trade-offs reais: custo por token, latência, tamanho da janela de contexto disponível, política de retenção de dados do provider e, principalmente, privacidade.
Outputs de pentest frequentemente contêm endereços IP internos, usernames, hashes, tokens, segredos de configuração e, em alguns casos, código proprietário do cliente. Enviar esse tipo de conteúdo para um provider externo de LLM deve passar pela mesma análise de segurança, compliance e política de dados que qualquer outra integração com terceiros — não é uma decisão puramente técnica de qual modelo “responde melhor”.
Construindo um laboratório controlado
Todos os exemplos operacionais deste artigo pressupõem execução em ambiente próprio: laboratório isolado, CTF, Hack The Box, TryHackMe, infraestrutura de treinamento ou engagement de pentest/Red Team formalmente autorizado. Nada aqui deve ser direcionado a infraestrutura de terceiros sem autorização explícita.
┌────────────────────────┐
│ Kali / PentestCode     │
│ 192.168.56.10          │
└───────────┬────────────┘
            │
       LAB ISOLADO
            │
     ┌──────┴──────┐
     │             │
     ▼             ▼
Web Vulnerável   Windows/AD Lab
192.168.56.20    192.168.56.30
Os endereços acima são exemplos de faixa privada de laboratório (RFC 1918), sem correspondência com infraestrutura real.
Um primeiro contato seguro com a ferramenta, após autenticação:
pentestcode auth login
pentestcode
E um prompt de exemplo com escopo explícito, direcionado exclusivamente ao laboratório:
Analise exclusivamente o host 192.168.56.20 do meu laboratório.
O objetivo é realizar reconhecimento e enumeração de serviços.
Não execute exploração sem solicitar aprovação.
Registre evidências e explique cada próximo passo.
O propósito deste exemplo é ensinar governança da autonomia — não demonstrar uma técnica de ataque contra terceiros.
Definindo scope antes da autonomia
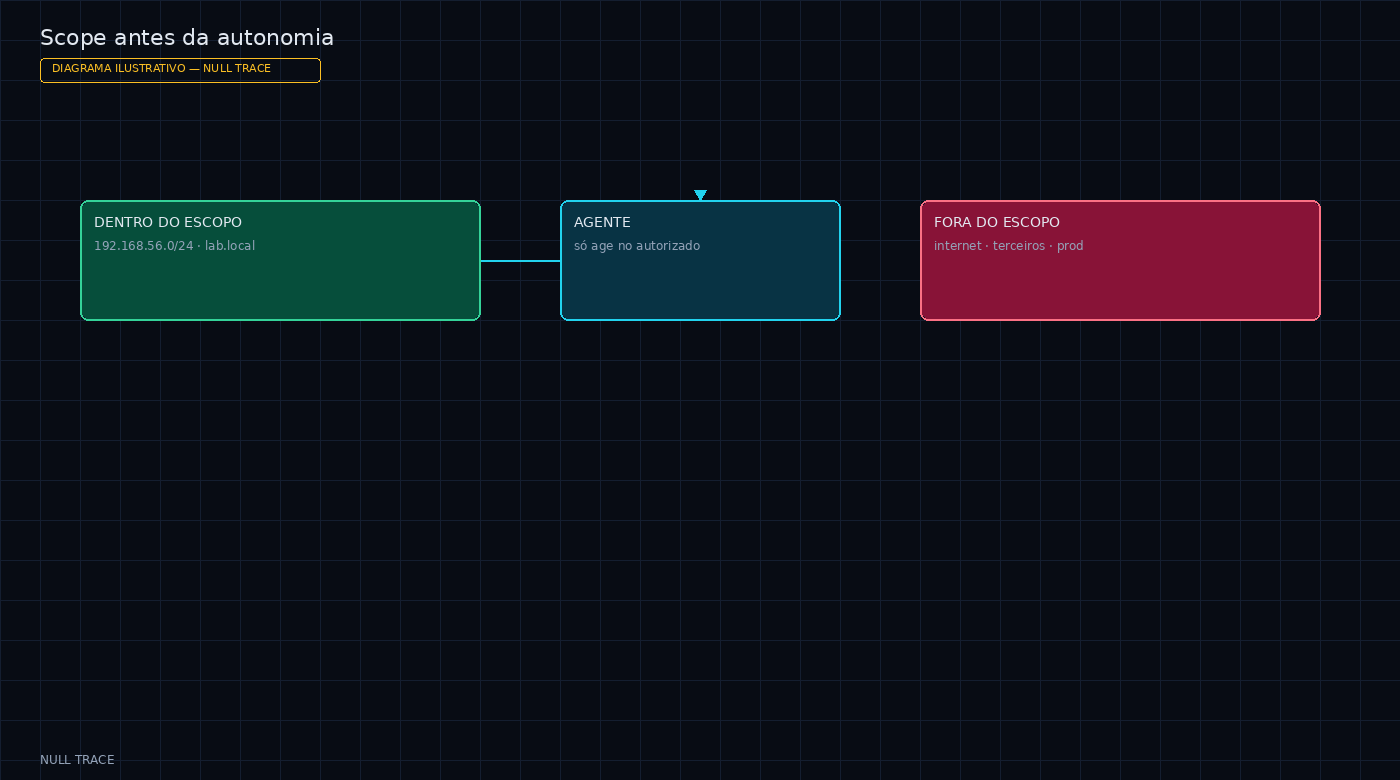
Sem scope escrito o agente não deve enumerar. O diagrama não é output de ferramenta.
Escopo é uma fronteira de segurança, não um detalhe burocrático — e essa fronteira se torna mais crítica, não menos, quando quem está executando as ações é um agente autônomo.
Um prompt vago como "pentest esse domínio" é perigoso justamente porque o domínio moderno raramente é uma entidade isolada: envolve subdomínios de terceiros, provedores SaaS, CDNs, ativos em nuvem compartilhados, IPs que não pertencem ao contratante e sistemas descobertos dinamicamente durante o próprio recon — nenhum dos quais necessariamente está coberto pela autorização do engagement.
Um modelo de escopo mais seguro é explícito em ambas as direções — o que está dentro e o que está fora:
Escopo autorizado:
- 192.168.56.0/24

Fora do escopo:
- qualquer outra rede
- serviços externos
- terceiros

Objetivo:
- Recon e enumeração

Restrições:
- não executar DoS
- não modificar dados
- não realizar persistence
- solicitar aprovação antes de exploração
O PentestCode documenta oficialmente uma ferramenta dedicada a isso — scope_check, para validação de escopo via CIDR/wildcard — além de um comando de sessão /scope para visualizar e editar o escopo do engagement em tempo real, e rastreia separadamente hosts descobertos que não estão explicitamente no escopo (recurso de “Discovered Targets” presente na versão mais recente do projeto). Isso é relevante: mesmo com essa infraestrutura de controle, a responsabilidade de definir corretamente o escopo inicial continua sendo do operador humano.
IA aplicada a Network Pentest
Um agente pode ajudar a correlacionar a superfície de um host de forma sistemática:
Host
 ↓
Porta
 ↓
Serviço
 ↓
Versão
 ↓
Possível superfície
 ↓
Enumeração específica
 ↓
Evidência
Um exemplo puramente ilustrativo de topologia de laboratório:
10.10.10.20
├── 22/tcp  SSH
├── 80/tcp  HTTP
├── 445/tcp SMB
└── 389/tcp LDAP
A presença de uma porta aberta não constitui vulnerabilidade — é, na melhor das hipóteses, uma hipótese a ser testada. O papel de um agente aqui é justamente formular essas hipóteses de forma organizada e testá-las sistematicamente, não declarar uma porta aberta como um “finding”.
O PentestCode documenta parsers dedicados que alimentam o estado do engagement diretamente a partir de ferramentas já consolidadas na comunidade: nmap_parse (XML do Nmap → popula hosts/serviços automaticamente), cme_parse (saída do NetExec → atualiza credenciais/acessos/hosts) e tunnel_manage (planejamento de túneis SSH/chisel/ligolo, com rastreio de sessões). O agente não substitui essas ferramentas — ele as orquestra e interpreta a saída delas.
IA aplicada a Web Security
Na frente web, o valor de um agente está em orquestrar reconhecimento, correlacionar achados e priorizar hipóteses — não em substituir ferramentas especializadas como Burp Suite, Nuclei, ffuf ou sqlmap.
Ferramenta especializada
        ↓
Dados brutos
        ↓
Parser / interpretação
        ↓
Estado do engagement
        ↓
Raciocínio do agente
        ↓
Próxima hipótese
O PentestCode documenta oficialmente essa camada de interpretação através de ferramentas como nuclei_parse (JSON do Nuclei → cria vulnerabilidades já classificadas por severidade), sqlmap_parse (saída do sqlmap → extrai pontos de injeção), xss_detect (análise de respostas HTTP em busca de XSS refletido/armazenado) e jwt_analyze (decodifica JWT, verifica alg:none, HMAC fraco e expiração). O agente webapp, especializado em OWASP Top 10, é quem consome essas evidências dentro da arquitetura multi-agent.
PentestCode em Bug Bounty
Em programas de bug bounty, a vantagem prática de um agente com estado persistente aparece menos na exploração em si e mais na organização: correlacionar dezenas ou centenas de ativos de um mesmo programa em um único estado coerente, sem depender de planilhas paralelas ou da memória do pesquisador para lembrar o que já foi testado em qual subdomínio.
O ponto crítico aqui é que um programa de bug bounty define escopo por contrato, não por rede. Um domínio pode ter subdomínios de terceiros, ativos explicitamente excluídos ou provedores SaaS fora do programa, e nada disso é óbvio a partir de uma simples varredura de DNS. Antes de apontar o agente para o alvo, vale formalizar por escrito o que está e o que não está autorizado:
AUTHORIZED TARGETS:
- *.exemplo-programa.com (conforme escopo publicado)

OUT-OF-SCOPE TARGETS:
- ativos de terceiros/CDN listados como excluídos
- qualquer domínio não mencionado explicitamente no programa

ALLOWED TESTS:
- reconhecimento passivo e ativo, enumeração, análise de vulnerabilidades web

FORBIDDEN TESTS:
- DoS, engenharia social, acesso a dados de outros usuários

STOP CONDITIONS:
- qualquer indício de acesso a dados reais de terceiros: parar e reportar
Esse bloco não é um recurso do PentestCode — é disciplina do operador, formalizada em texto antes de qualquer prompt. O /scope e o scope_check mencionados anteriormente ajudam a impedir que o agente se mova sozinho para um ativo fora dessa lista, mas a lista em si só existe se o pesquisador a definir a partir das regras reais do programa — a ferramenta não conhece os termos do bug bounty, só o CIDR/wildcard configurado nela.
Active Directory e correlação de attack paths
Ambientes de Active Directory são um caso de uso particularmente adequado para agentes com estado persistente, porque a superfície de ataque real em AD quase sempre emerge da correlação entre múltiplas fontes — LDAP, SMB, Kerberos, usuários, grupos, computadores, relações de confiança, privilégios e misconfigurations — não de uma vulnerabilidade isolada.
O PentestCode mantém um modelo de Active Directory dedicado dentro do engagement state (domain controllers, trusts, administradores, políticas de senha, GPOs), populado por parsers como bloodhound_parse (consome JSON do SharpHound diretamente). O agente identity, especializado em AD/Kerberos, é responsável por essa frente.
Um exemplo conceitual de como evidências dispersas podem convergir em uma hipótese de attack path:
Low-Privilege User
        │
        ▼
LDAP Enumeration
        │
        ▼
Misconfiguration
        │
        ▼
Credential / Permission Finding
        │
        ▼
New Access
        │
        ▼
Lateral Movement Candidate
É fundamental manter clara a distinção: candidate path ≠ confirmed compromise. O PentestCode documenta o cálculo de attack paths via attack_path_suggest, usando Dijkstra com custo sobre o grafo de relacionamentos (EXPLOITED_VIA, ADMIN_OF, PIVOT_TO) — mas um caminho calculado é uma hipótese de rota, não uma prova de comprometimento. Cada vulnerabilidade no estado carrega um status explícito (suspeita/confirmada/explorada) e um score de confiança justamente para preservar essa distinção.
Quem quiser aprofundar a leitura sobre triagem e correlação de evidências em Active Directory sob uma ótica defensiva pode conferir PowerShell para DFIR — Parte 2: Encontrando Persistência no Windows, publicado anteriormente aqui no Null Trace.
Post-Exploitation
Esta etapa exige a maior contenção editorial e a maior disciplina operacional. Conceitualmente, envolve avaliar o contexto de privilégio obtido, credenciais encontradas, hosts alcançáveis a partir do ponto de acesso, serviços internos expostos e potencial de pivoting.
A ênfase aqui não é em “o que mais é possível fazer”, mas em: autorização explícita para cada etapa adicional, impacto mínimo necessário para comprovar o risco, coleta disciplinada de evidências, cleanup ao final do engagement e logging completo para rastreabilidade. Um agente autônomo executando pós-exploração sem esses controles amplia o risco operacional — não porque a IA seja “mais perigosa” que um humano, mas porque pode executar mais rápido e com menos hesitação natural do que um analista.
Human-in-the-Loop
O PentestCode documenta oficialmente três modos de execução via comando /mode:
- auto — execução autônoma através das fases do pentest, disparando subagentes conforme necessário;
- free — sem estrutura de fases, responde a solicitações diretas e contorna as checagens de escopo (uso deliberadamente restrito a contextos onde isso é aceitável);
- guided — confirmação passo a passo: o agente propõe cada ação e aguarda aprovação antes de executar.
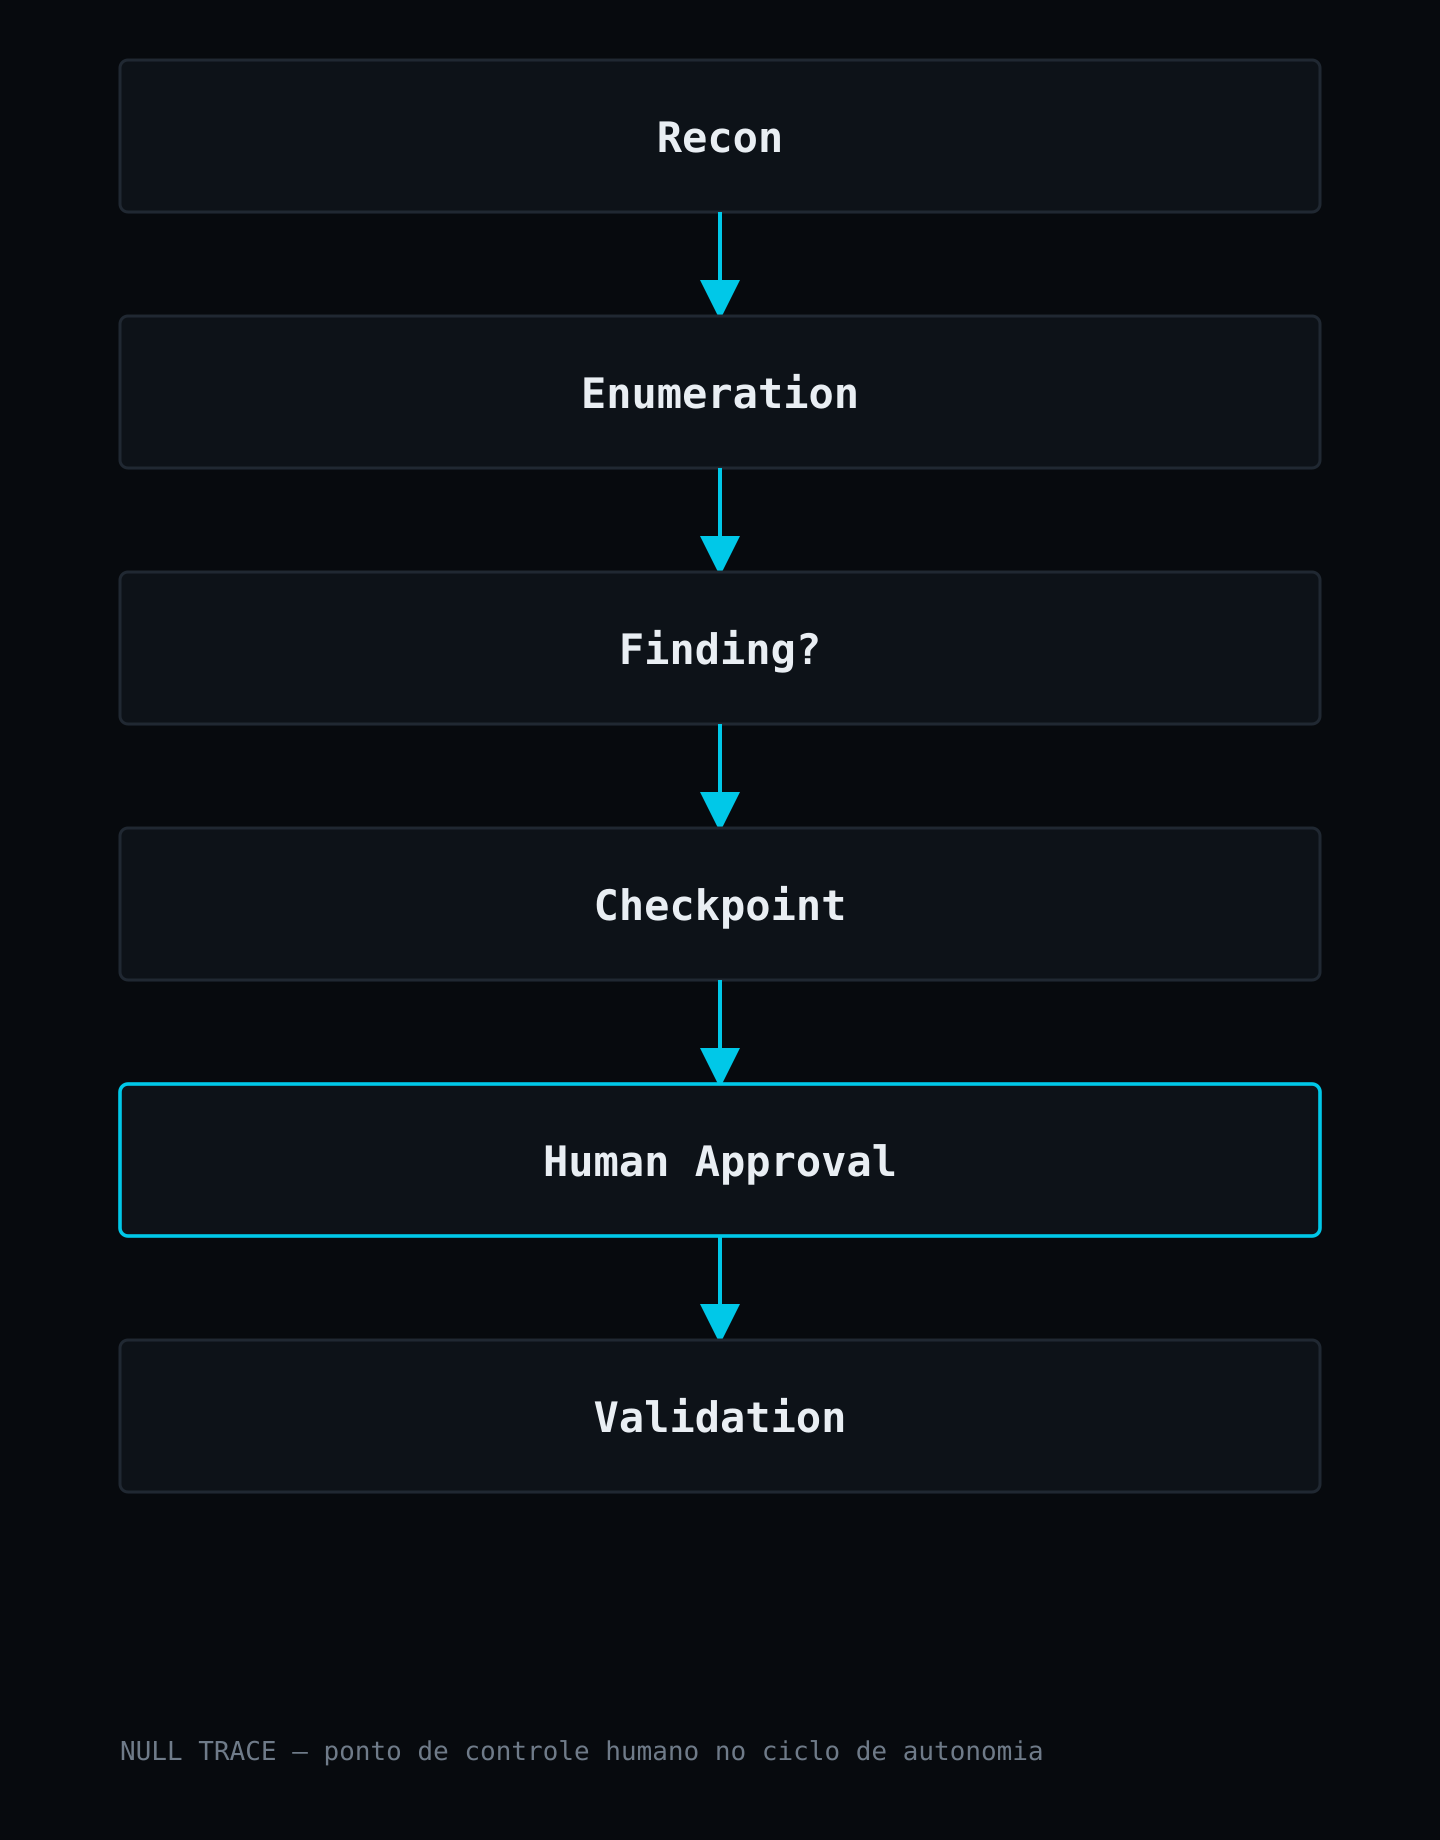
O comando /pause controla explicitamente o comportamento de pausa (never/always/checkpoint), e é essa a peça central de governança de autonomia. Três modelos operacionais resumem a ideia: assistido (IA recomenda → humano executa), semi-autônomo (IA executa Recon/Enumeration → pede autorização para etapas sensíveis) e autônomo dentro de sandbox (o agente recebe maior liberdade somente em laboratório isolado). Vale notar que o modo free, por contornar checagem de escopo, é o que exige mais atenção editorial e operacional — não é o modo recomendado para engagements formais sem supervisão adicional.
Reporting assistido por IA
Um finding tecnicamente útil precisa conter, no mínimo:
Título
Severidade
Ativo afetado
Evidência
Descrição técnica
Impacto
Passos de validação
Mitigação
Referências técnicas
O PentestCode oferece essa estrutura via comando /report (gerando relatórios em markdown ou JSON) e mantém, em paralelo, um log human-readable com timestamp, cadeia de evidências e classificação de severidade para cada achado — reduzindo consideravelmente o trabalho mecânico de transformar anotações dispersas em um relatório formal.
Para ler o relatório em markdown direto no terminal, com formatação legível, em vez de abrir um editor separado, uma opção prática é o glow:
sudo apt install glow
glow report.md
O risco correspondente precisa ser dito sem meias palavras: um LLM pode gerar uma narrativa tecnicamente convincente para uma conclusão incorreta. Um finding produzido automaticamente — por mais bem redigido que esteja — precisa ser revisado por um analista antes de virar entrega ao cliente. Relatório gerado por IA nunca deve ser tratado como evidência primária.
Quando um agente alucina durante um pentest
Alucinação em contexto ofensivo tem consequências específicas: inventar um CVE que não existe, associar a versão errada de um serviço a uma vulnerabilidade conhecida, concluir sucesso a partir de um output ambíguo, interpretar um HTTP 200 genérico como evidência de exploração, confundir uma mensagem de erro com acesso obtido, repetir uma técnica que já foi tentada e falhou, extrapolar a topologia de rede além do que foi realmente observado, sugerir um comando tecnicamente inadequado, ou declarar uma escalação de privilégio que nunca ocorreu.
O princípio organizador é simples de enunciar:
LLM hypothesis
      ≠
Security finding
Para uma hipótese se tornar um finding legítimo, ela precisa passar por um caminho de validação:
Hypothesis
   ↓
Technical validation
   ↓
Reproducible evidence
   ↓
Impact assessment
   ↓
Finding
É exatamente esse tipo de controle que o agente critic do PentestCode formaliza — sua função documentada é a validação de falsos positivos antes que um achado seja consolidado no estado do engagement. A existência desse agente dedicado é, em si, um reconhecimento arquitetural de que alucinação é um risco esperado, não hipotético, em sistemas desse tipo. E vale reforçar um princípio geral, também descrito na documentação: uma afirmação de sucesso não vale nada sem evidência verificável de identidade, privilégio, host e contexto — “provavelmente consegui acesso” não é um resultado, é uma hipótese não testada.
O que o Blue Team consegue observar
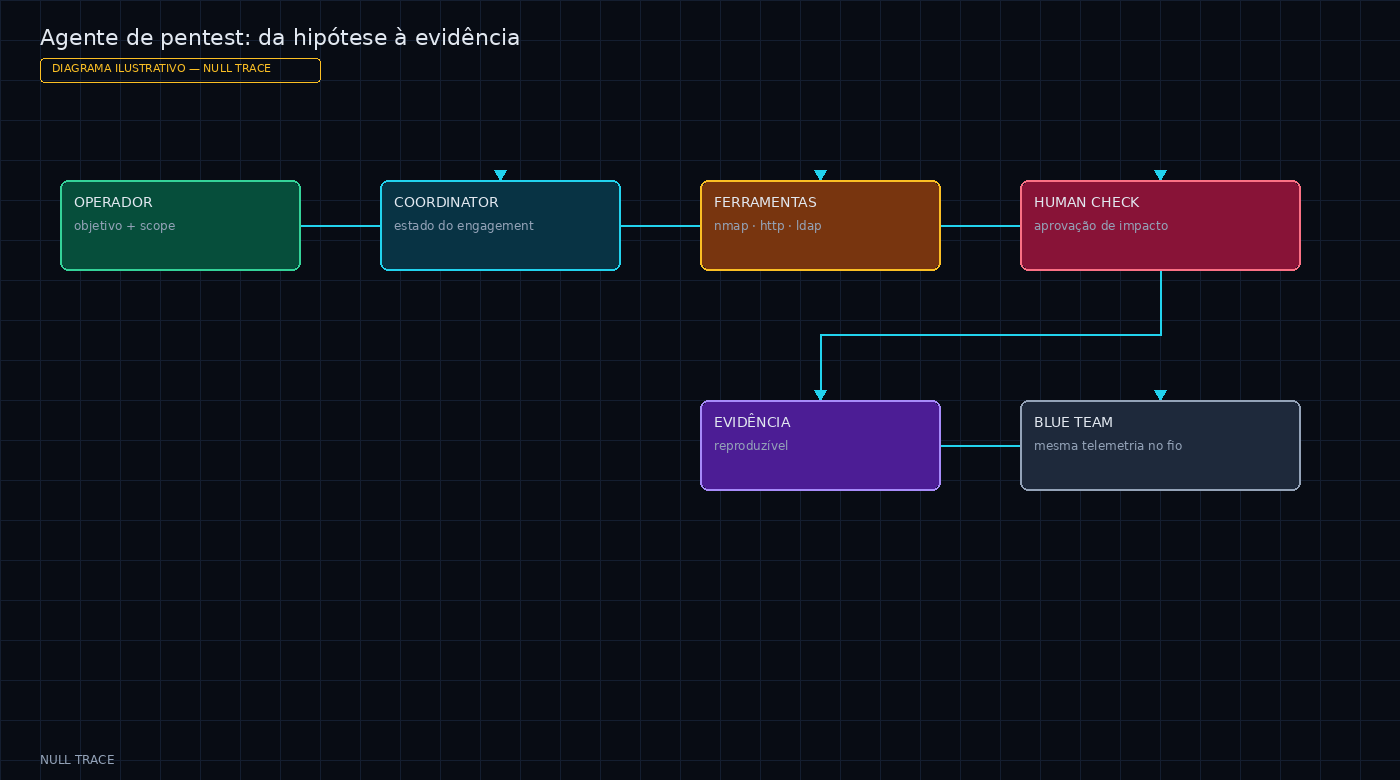
A telemetria que o Blue Team vê continua sendo a das ferramentas lançadas, não a do modelo.
Este é o ponto onde a perspectiva defensiva precisa entrar com força: um agente de IA ainda executa ações observáveis. A velocidade e a capacidade de adaptação mudam; os artefatos produzidos pelas ferramentas subjacentes, não necessariamente.
Fontes de telemetria relevantes continuam sendo as mesmas de sempre: firewall, proxy, DNS, EDR, Sysmon, Windows Event Logs, logs de servidor web, WAF, Active Directory, LDAP, SMB, Kerberos, logs de auditoria de banco de dados, logs SSH e logs de auditoria de nuvem.
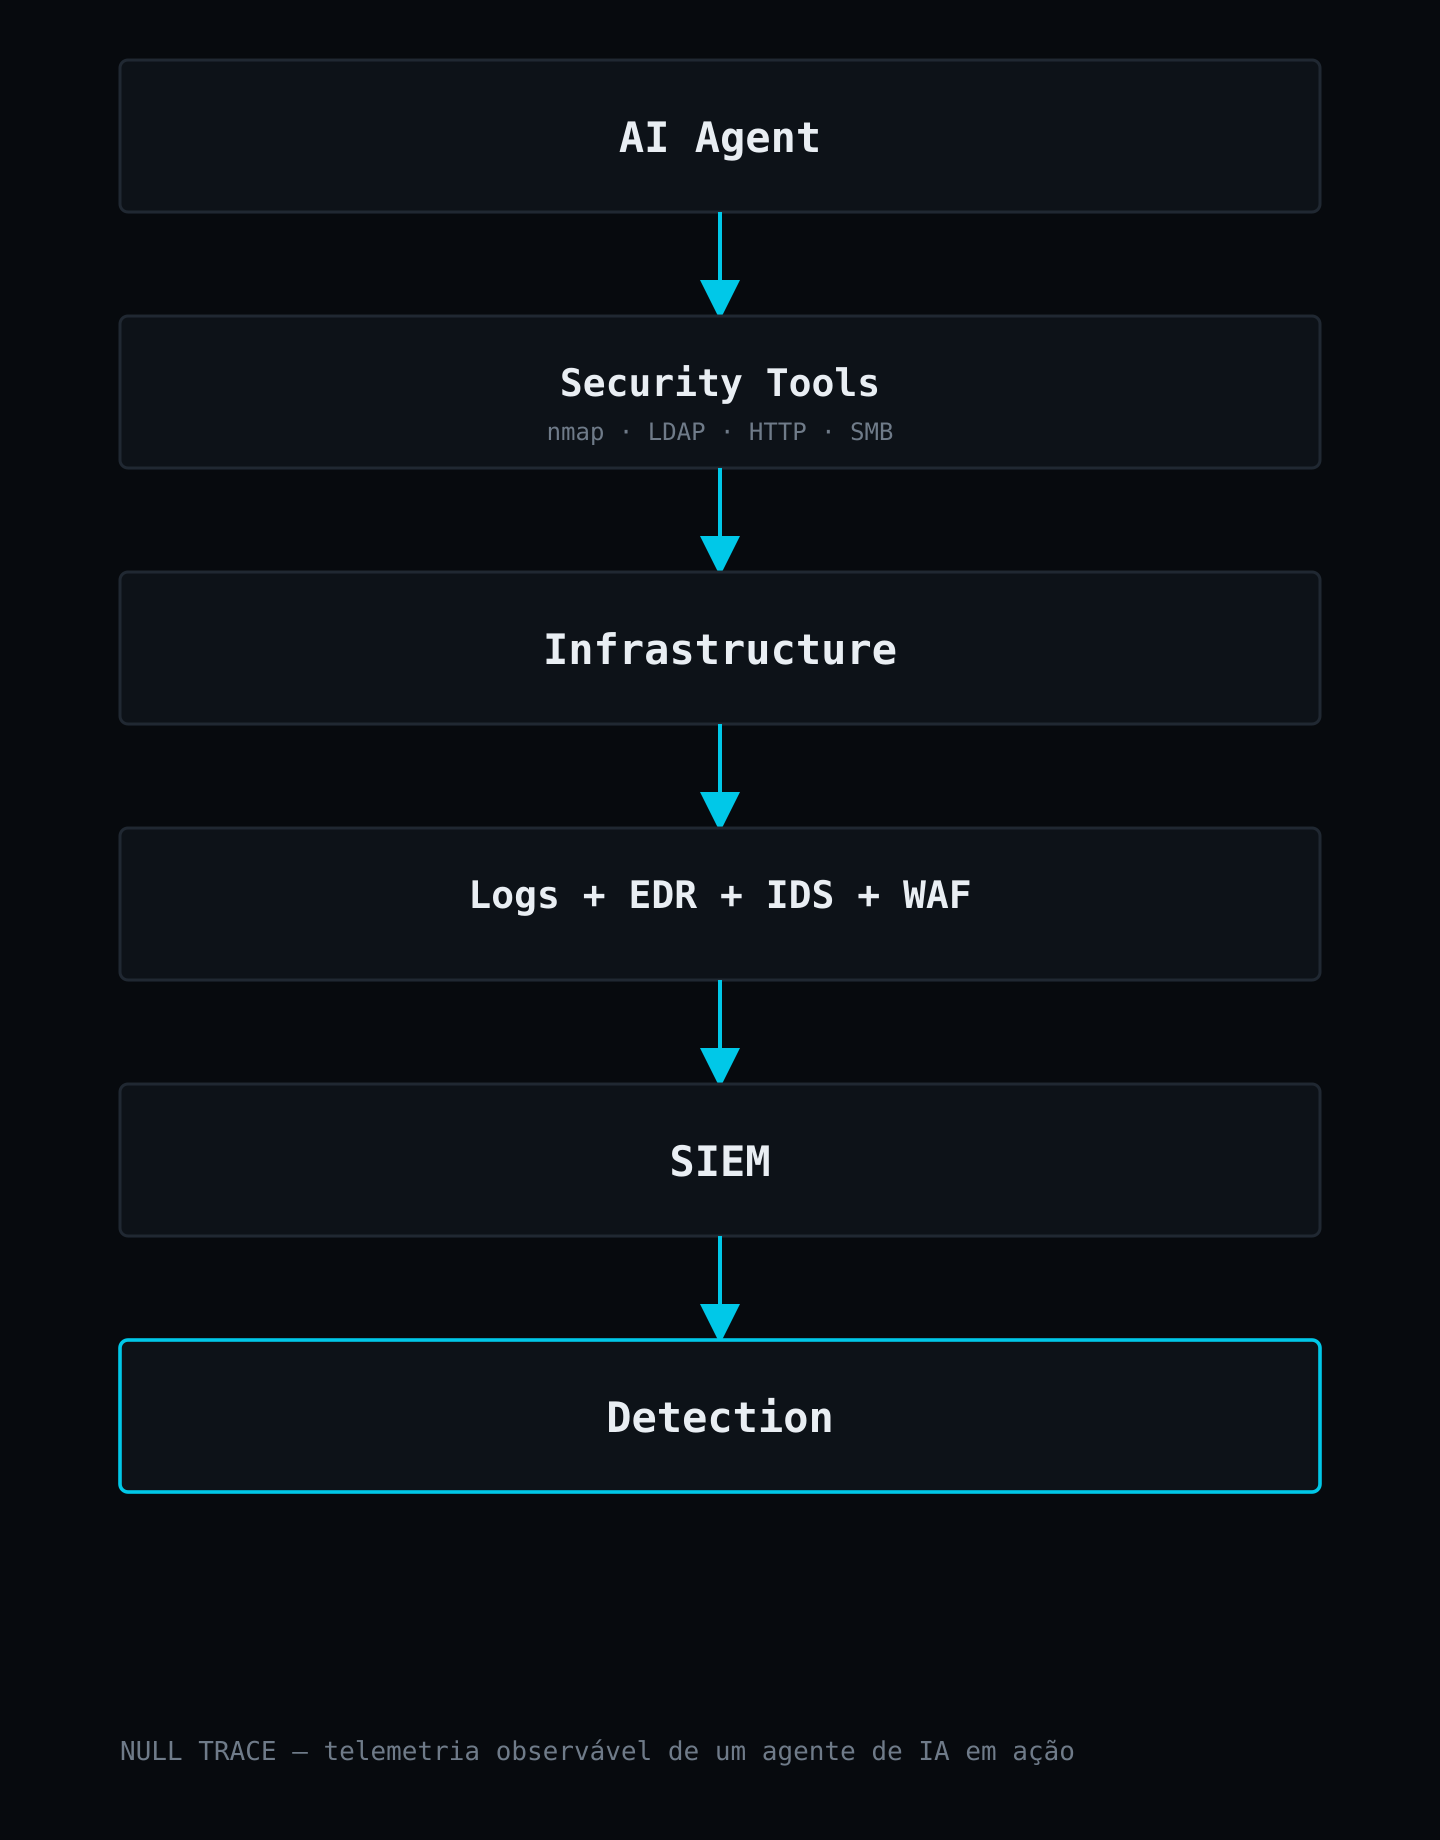
Um nmap_parse só existe porque, antes dele, um nmap real varreu uma rede real e gerou tráfego real. Um bloodhound_parse só existe porque um SharpHound real coletou dados reais do AD. A camada de IA reorganiza a decisão sobre qual ferramenta rodar e quando — ela não torna a execução da ferramenta invisível.
Do ponto de vista comportamental, alguns padrões merecem atenção quando a velocidade e a sequência da atividade destoam do normal: bursts de enumeração concentrados em curto intervalo, múltiplos protocolos testados em sequência rápida, LDAP seguido imediatamente por SMB, scanning amplo seguido de enumeração cirurgicamente focada, e múltiplas ferramentas distintas originando-se do mesmo host em uma janela curta de tempo. Nenhum desses padrões é um indicador de comprometimento universal por si só — administradores legítimos e ferramentas de auditoria também podem produzir sequências semelhantes. Contexto é sempre necessário.
Riscos de segurança ao usar IA para pentest
Prompt Injection e outros riscos de Agentic Security
Um agente que analisa conteúdo controlado pelo alvo — o HTML de uma aplicação, um arquivo de configuração, a resposta de um serviço — está, por definição, processando dados não confiáveis. Isso abre uma classe de risco que não existe em pentest manual da mesma forma: instruções maliciosas embutidas nesse conteúdo, desenhadas para influenciar o raciocínio do modelo.
A distinção central que precisa ficar clara é conceitual: dados provenientes do alvo não é o mesmo que instruções autorizadas pelo operador. Conceitualmente, o caminho de risco é:
Target Content
     ↓
UNTRUSTED DATA
     ↓
Parsing / sanitization
     ↓
Agent reasoning
Se um parser ou o próprio modelo não separar claramente “isto é evidência para analisar” de “isto é um comando a seguir”, o sistema fica exposto a indirect prompt injection (instrução escondida em conteúdo do alvo), tool poisoning (saída manipulada de uma ferramenta influenciando decisões subsequentes) e falha na fronteira de confiança entre comando e evidência.
Este é apresentado deliberadamente como um risco arquitetural geral de sistemas agentic — não há evidência específica, pública e verificada de que o PentestCode seja vulnerável a isso, e nenhuma afirmação nesse sentido é feita aqui. O ponto editorial é: qualquer arquitetura agentic que processa dados de um alvo não confiável precisa ser projetada com essa fronteira em mente, e times de segurança avaliando esse tipo de ferramenta deveriam perguntar explicitamente como ela trata essa separação.
Autonomia não significa ausência de controle
Esta é uma representação conceitual para orientar decisão de governança — não uma métrica medida ou benchmark. O ponto central é que autonomia crescente desloca risco de “erro humano por lentidão ou tédio” para “erro sistêmico por falta de supervisão em tempo real” — e o segundo tipo de erro tende a escalar mais rápido antes de ser percebido.
Onde esses agentes realmente ajudam
Os pontos fortes documentados e observáveis na arquitetura são concretos: correlacionar grande volume de dados de múltiplas ferramentas em um único estado coerente, reduzir tarefas mecânicas e repetitivas, organizar findings de forma estruturada e consistente, sugerir caminhos de investigação a partir de evidências já coletadas, interpretar outputs técnicos densos, manter contexto ao longo de um engagement longo, gerar documentação preliminar e coordenar tarefas paralelas entre especialistas.
Onde ainda dependem do pentester
Os pontos fracos são igualmente reais: contexto de negócio incompleto, lógica de negócio específica que não segue padrões genéricos, exploração que exige criatividade fora de padrões conhecidos, ambientes não padronizados ou legados mal documentados, falsos positivos, outputs ambíguos que exigem julgamento humano, fluxos de autenticação complexos, decisões de natureza legal ou contratual, avaliação de risco no contexto real do negócio, operação furtiva calibrada para um adversário específico e regras muito específicas de um engagement individual.
A narrativa de que “IA vai substituir pentesters” não se sustenta tecnicamente diante desses limites. O que se sustenta é complementaridade: o agente absorve volume e repetição; o analista absorve julgamento, contexto e responsabilidade.
Pentester como orquestrador
Pentester tradicional
       ↓
opera ferramentas diretamente

Pentester com IA
       ↓
define objetivo
       ↓
define limites
       ↓
coordena agentes
       ↓
valida evidências
       ↓
interpreta impacto
       ↓
assume responsabilidade
A expertise técnica não se torna menos necessária nesse modelo — ela se torna mais necessária em um ponto específico: saber reconhecer quando o agente está errado. Um analista que não entende profundamente SMB, Kerberos ou HTTP não consegue avaliar se a conclusão de um agente sobre esses protocolos faz sentido — só consegue aceitá-la ou rejeitá-la às cegas.
Cheat Sheet operacional
Conclusão
O PentestCode representa uma mudança arquitetural, não apenas uma nova interface para um LLM:
LLM
  +
Tools
  +
Memory
  +
State
  +
Orchestration
  +
Human Oversight
é substancialmente diferente de simplesmente usar um chatbot para pedir sugestões de comando. Um coordenador que despacha 13 agentes especializados, mantém um grafo de relacionamentos entre credenciais e hosts, calcula rotas de attack path e persiste evidências entre sessões é, por definição, um sistema — não uma conversa.
Ao mesmo tempo, quanto maior a autonomia, maior a necessidade de escopo bem definido, evidência verificável, observabilidade completa, validação técnica de cada hipótese, checkpoints de aprovação e, no fim, responsabilidade humana por cada decisão relevante. Nada nessa arquitetura elimina a necessidade dessas camadas — pelo contrário, a própria existência de um agente critic dedicado a validar falsos positivos, de um comando /pause configurável e de rastreamento explícito de targets fora do escopo é evidência de que os próprios desenvolvedores do projeto reconhecem esses riscos como centrais, não periféricos.
O verdadeiro valor da IA em Cybersecurity não está em eliminar o analista — está em ampliar sua capacidade de coordenar informação e operações, desde que cada decisão relevante continue vinculada a evidência, contexto e autorização.


