NT-2026.08.27 DOSSIÊ RED TEAM
SLIVER C2: PERSISTÊNCIA WINDOWS EM OPERAÇÕES DE RED TEAM
Como o Sliver C2 gera mecanismos de persistência no Windows — Scheduled Tasks, Registry, Startup, Services — mapeados ao MITRE ATT&CK, com os artefatos e a telemetria que cada técnica deixa para o Blue Team detectar.
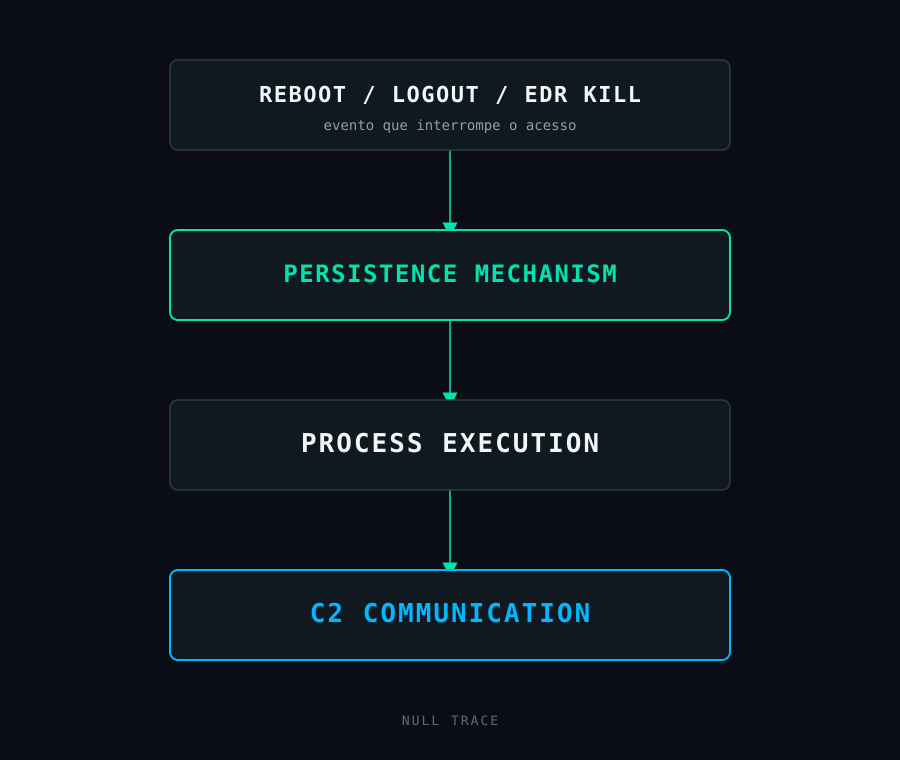
Uma sessão não é acesso garantido. Ela desaparece quando o processo termina, quando o usuário faz logout, quando a máquina reinicia, quando a conexão cai ou quando o EDR simplesmente mata o processo. Tudo o que foi conquistado até ali — o foothold, os privilégios, o contexto do host — some junto.
É para esse problema que existe persistência: o conjunto de mecanismos que fazem um código voltar a executar depois de uma dessas interrupções, sem depender de repetir a exploração inicial. E é também, por definição, a fase de um engagement que mais artefatos deixa no disco, no registro e na rede — o que faz dela tão relevante para quem ataca quanto para quem defende.
Este artigo usa o Sliver, framework de C2 open source mantido pela Bishop Fox, como fio condutor para explicar os mecanismos clássicos de persistência no Windows — não como uma coleção de comandos para copiar e colar, mas seguindo a cadeia completa: técnica → comportamento → artefato → telemetria → detecção → mitigação.
Os exemplos e conceitos apresentados neste artigo são destinados a laboratórios, CTFs, ambientes próprios e operações de segurança explicitamente autorizadas.
O que é o Sliver C2?
O Sliver é um framework de adversary emulation/Red Team open source (GPLv3), mantido pela Bishop Fox, com arquitetura cliente/servidor: um servidor central gerencia listeners, sessões e a compilação sob demanda dos implants, enquanto operadores se conectam a esse servidor — inclusive em modo multiplayer, várias pessoas na mesma operação — para interagir com os hosts comprometidos.
Cada implant é compilado dinamicamente, com chaves de criptografia assimétrica próprias por binário, o que dificulta a detecção baseada em assinatura estática reaproveitada entre operações. A documentação oficial confirma quatro transportes de C2 disponíveis: mTLS, HTTP(S), DNS e WireGuard — cada um com características diferentes de latência, capacidade de passar por proxy/firewall e forma como aparece na telemetria de rede.
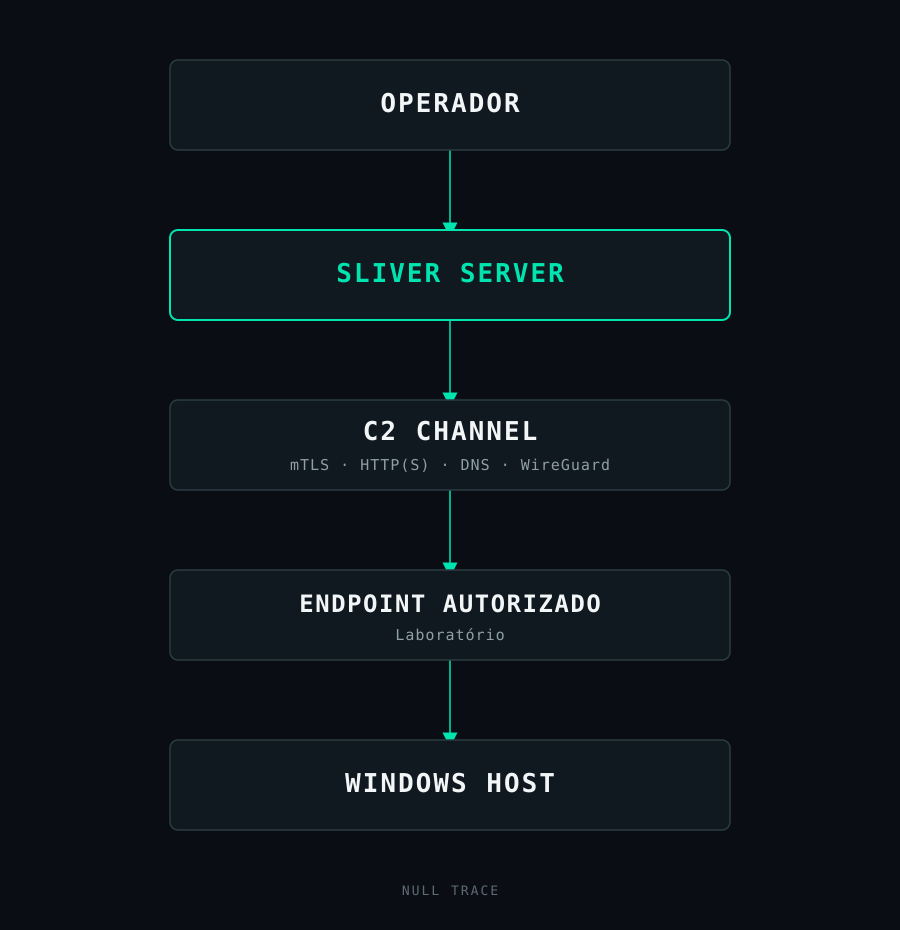
O ponto importante para o restante deste artigo: nada nessa arquitetura é, por si só, um mecanismo de persistência. Sliver entrega acesso enquanto a sessão dura. O que faz esse acesso sobreviver a um reboot ou a um logout é uma camada separada — é essa camada que este artigo detalha.
Session vs Beacon: entendendo a comunicação
O Sliver opera implants em dois modos de comunicação. Session mantém uma comunicação próxima de tempo real: o operador interage com o host como se estivesse numa espécie de shell remoto, com resposta praticamente imediata. Beacon funciona de forma assíncrona — o implant “acorda” em intervalos configurados, verifica se há tarefas pendentes no servidor, executa e volta a dormir.
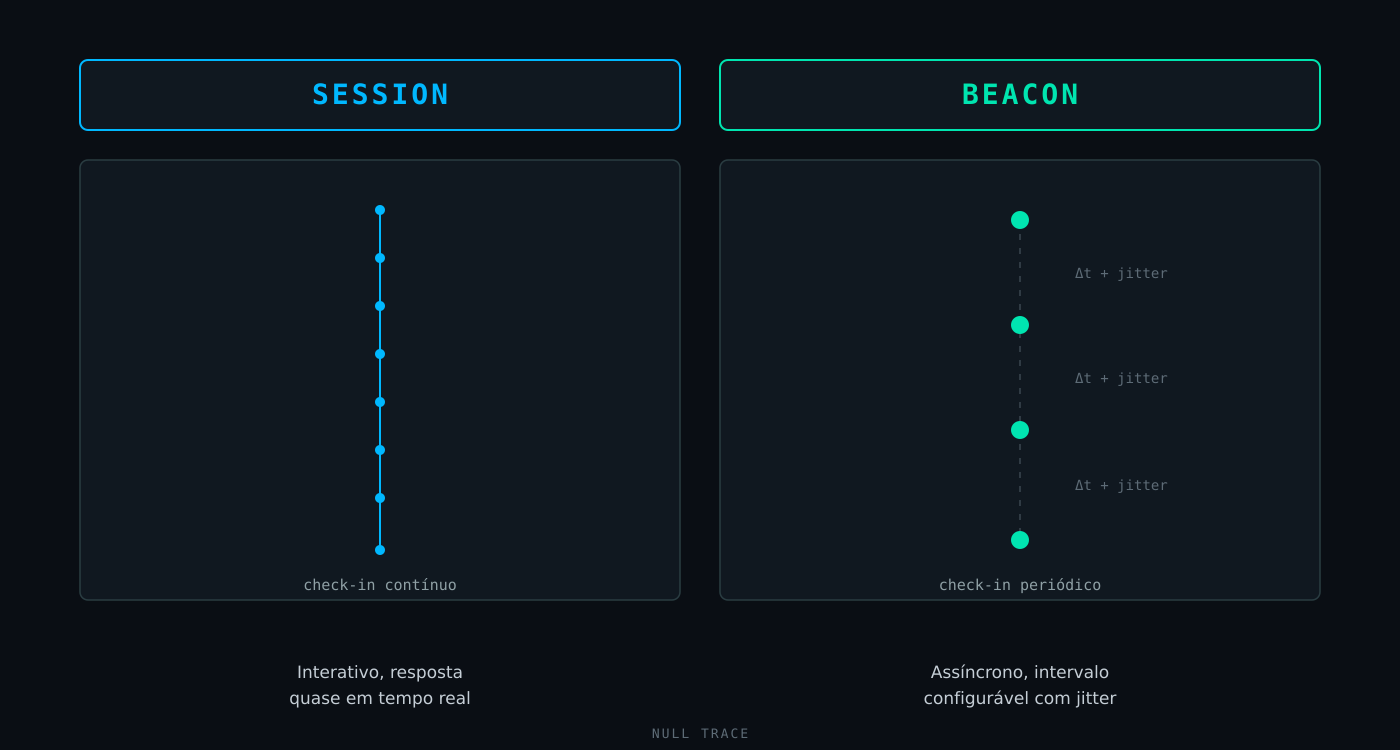
Nenhum dos dois modos deve ser tratado como “indetectável”. Beacon reduz o volume de tráfego constante, o que pode dificultar uma detecção baseada só em “conexão longa e persistente”, mas troca isso por um padrão periódico que é exatamente o tipo de sinal que ferramentas de detecção de beaconing (analisando intervalo e jitter) são desenhadas para achar. Session, por sua vez, gera uma conexão mais constante, mais fácil de correlacionar com uma janela de tempo específica. São trade-offs, não invisibilidade.
Persistence: mantendo acesso após uma interrupção
Vale separar quatro conceitos que costumam se misturar na conversa sobre pós-exploração:
- Persistência — o mecanismo que faz um código executar novamente após reboot, logout ou outra interrupção, sem nova exploração.
- Execução — o ato de rodar código no host, uma vez (persistência depende de execução, mas execução isolada não é persistência).
- Privilégio — o nível de acesso sob o qual esse código roda (persistência pode existir em qualquer nível de privilégio, e algumas técnicas inclusive escalam privilégio como efeito colateral).
- C2 — o canal de comunicação de volta ao operador (persistência garante que o C2 seja reestabelecido, não é o C2 em si).
Conceitualmente, o ciclo é sempre uma variação do mesmo padrão: um evento de sistema aciona um mecanismo, que executa um processo, que reestabelece a comunicação.
Mapeamento MITRE ATT&CK
Cada técnica abordada neste artigo tem ID e tática confirmados diretamente no MITRE ATT&CK — nenhum ID abaixo foi presumido.
Um detalhe que vale registrar por si só: Registry Run Keys e Startup Folder são a mesma subtécnica (T1547.001) no MITRE — não duas técnicas separadas, mesmo sendo mecanismos tecnicamente diferentes. Ambos exploram o mesmo conceito (autostart no boot/logon), só variam no artefato.
Laboratório controlado
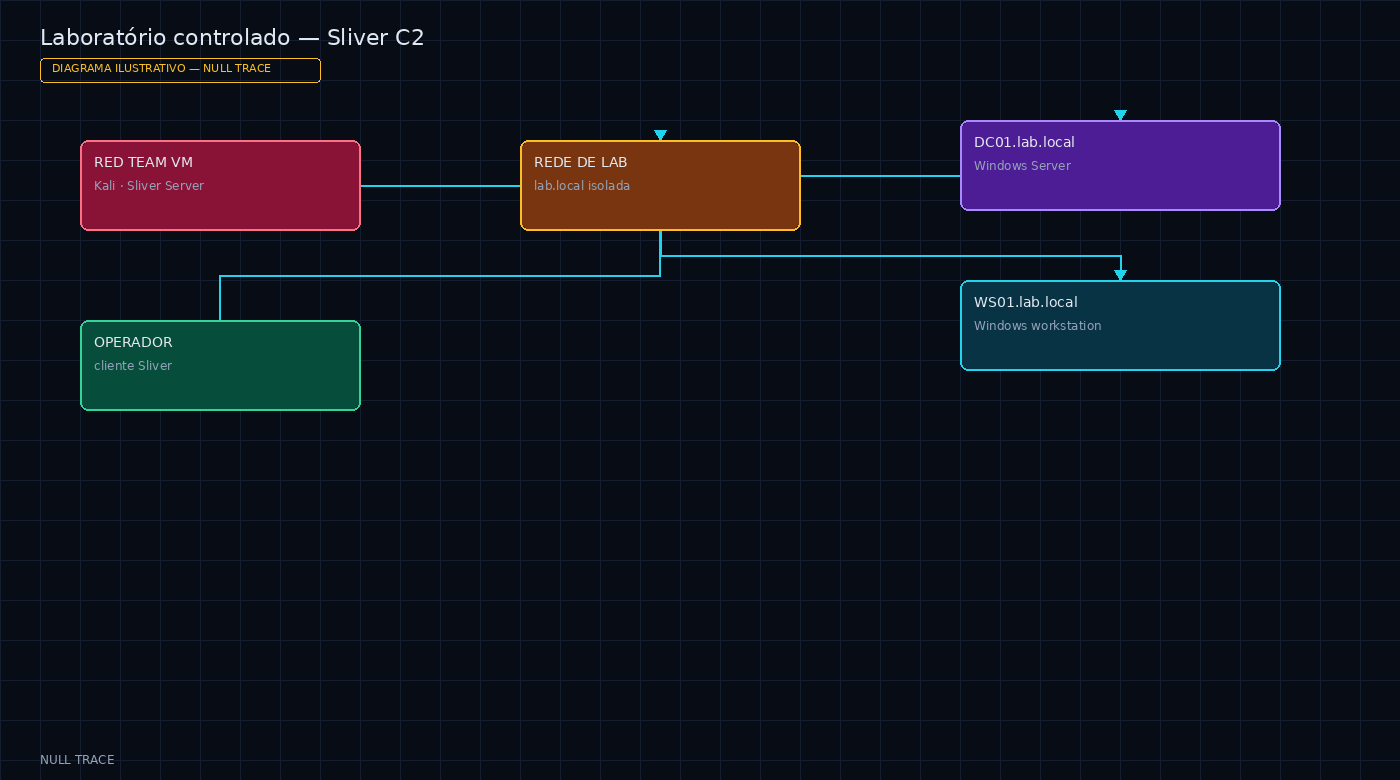
O diagrama resume o recinto do lab; não é captura de sessão C2. Os nomes lab.local, DC01 e WS01 são fictícios.
Toda técnica operacional deste artigo pressupõe um laboratório isolado — nunca infraestrutura de terceiros. Uma montagem mínima:
┌─────────────────┐
│ RED TEAM VM     │
│ Kali Linux      │
│ Sliver Server   │
└────────┬────────┘
         │
     LAB NETWORK (ex.: 192.168.56.0/24)
         │
┌────────▼────────┐
│ WINDOWS LAB     │
│ Test Endpoint   │
└─────────────────┘
O endereçamento acima é um exemplo de faixa privada de laboratório (RFC 1918), sem relação com infraestrutura real. Máquinas virtuais isoladas, um Windows de teste sem dados reais e snapshots para reverter o ambiente depois de cada rodada resolvem a grande maioria dos casos de estudo deste artigo.
Geração de implants: payload não é persistência
Antes de qualquer mecanismo de persistência, existe o implant em si — o binário que, uma vez executado, estabelece a comunicação C2. No console do Sliver, isso passa pelo comando generate, que aceita (entre outras) as flags --os, --arch, --format e --save para definir a saída, e uma flag por transporte — --mtls, --http, --dns ou --wg — para escolher o canal C2 do implant gerado:
sliver > generate --http --os windows --arch amd64 --format exe --save /tmp/implant.exe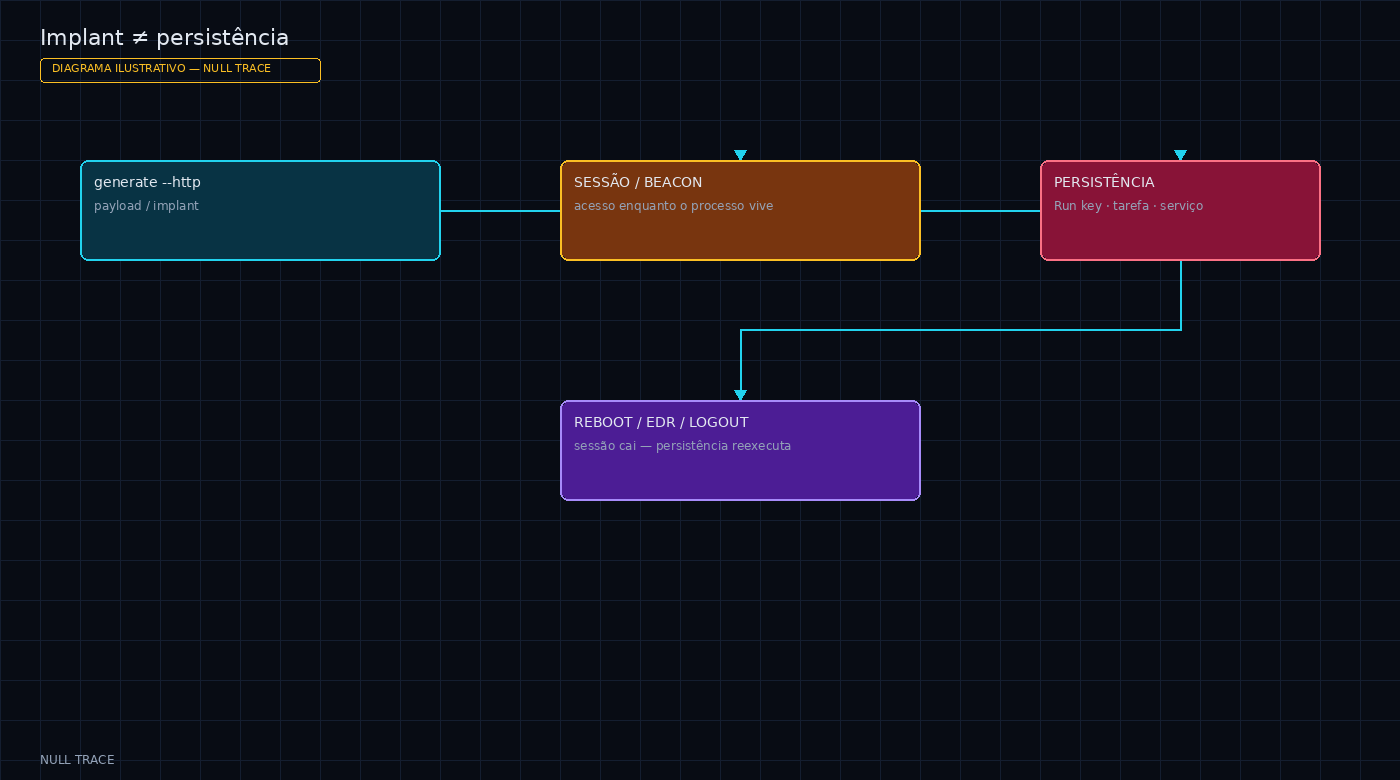
O comando copiável gera um binário. Isso não grava Run key, tarefa ou serviço. A persistência só começa quando um mecanismo de autostart é configurado no Windows do lab.
Isso gera um executável. Executá-lo uma vez é execução, não persistência — se o host reiniciar ou o processo morrer, o acesso some. É exatamente essa lacuna que os mecanismos das próximas seções fecham: cada um deles é, na prática, uma forma de reexecutar esse mesmo implant (ou um novo, gerado especificamente para isso) depois de um gatilho do sistema — boot, logon ou um intervalo de tempo.
Persistência através de Scheduled Tasks
O Task Scheduler do Windows permite configurar triggers (boot, logon, horário, evento) e actions (o que executar) sob um contexto de usuário específico — inclusive SYSTEM, se quem cria a tarefa tiver privilégio para isso. É um dos mecanismos mais usados justamente porque é nativo do sistema operacional: não requer instalar nada, só criar uma entrada.
No Sliver, a criação da tarefa passa pela execução de um binário nativo do Windows através do comando execute da sessão/beacon — o mecanismo em si não é uma “feature” do Sliver, é uma funcionalidade padrão do schtasks.exe do próprio sistema, apenas disparada remotamente através do implant.
Como detectar
O Windows registra a criação de tarefas agendadas no log de Segurança através do Event ID 4698 (“A scheduled task was created”), que inclui o nome da tarefa, quem criou e o XML completo da definição — incluindo o comando configurado na action. É esse XML que costuma entregar o indicador mais direto: um <Command> apontando para um caminho incomum, ou um TaskName genérico demais (“Windows Services and Tasks”, por exemplo) tentando se camuflar entre tarefas legítimas.
Sysmon complementa isso do lado da execução: Event ID 1 (Process Create) mostra o processo real disparado pela tarefa, com linha de comando completa e hash. A cadeia de investigação típica:
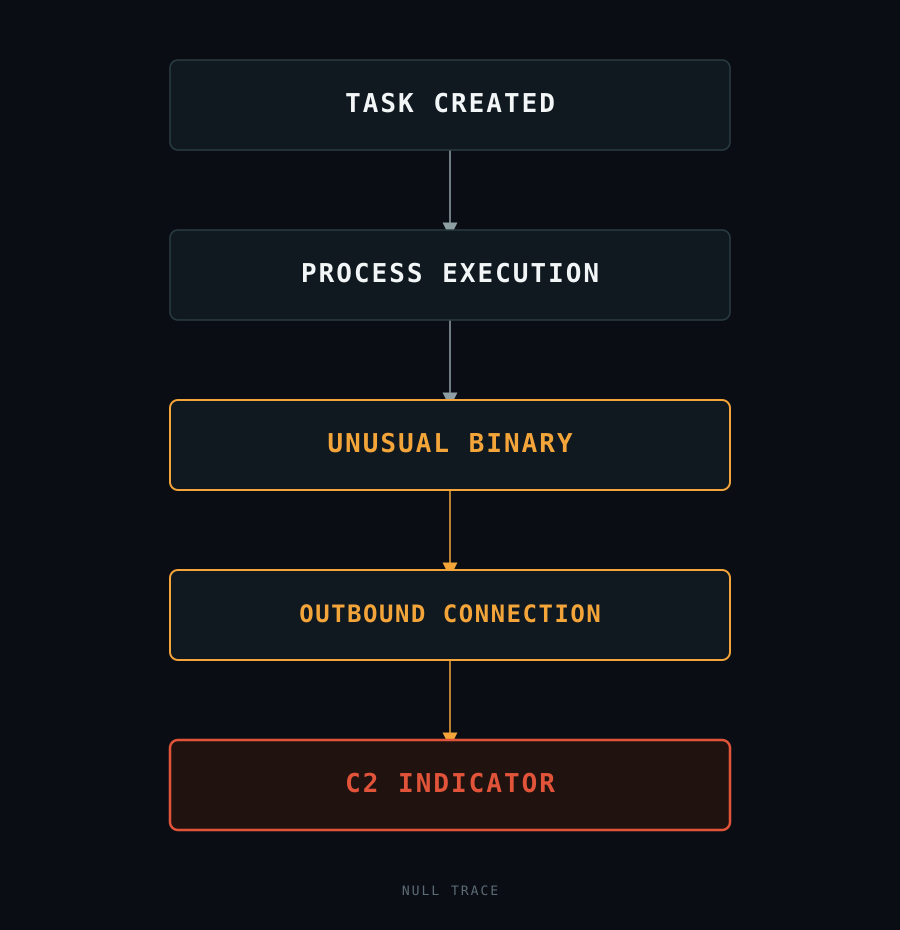
Sinais que aumentam a confiança de que uma tarefa é maliciosa: binário rodando de um diretório gravável pelo usuário comum (em vez de Program Files ou System32 legítimo), nome de tarefa sem relação com nenhum software instalado, horário de criação fora de qualquer janela de manutenção conhecida, e — o sinal mais forte — uma conexão de rede de saída logo após a execução do processo.
Startup Folder
O mecanismo é o mais simples de todos: qualquer executável, atalho (.lnk) ou script colocado na pasta de inicialização do usuário ou do sistema roda automaticamente no próximo logon. Não exige privilégio elevado quando usado na pasta do usuário atual, e não depende de nenhuma API além de escrever um arquivo.
LOGIN
  ↓
STARTUP FOLDER
  ↓
PROGRAM
  ↓
EXECUTION
Detecção
Sysmon Event ID 11 (FileCreate) é o sinal primário — a própria documentação oficial do Sysmon cita monitorar locais de autostart como Startup como um dos usos centrais desse evento. Vale correlacionar: arquivo recém-criado na pasta de startup, processo pai que o criou (um implant executando diretamente de memória tende a não ter um instalador legítimo por trás), tipo de arquivo (executável, script ou atalho apontando para outro lugar do disco) e, de novo, qualquer conexão de rede que se siga à primeira execução automática após o logon seguinte.
Registry Run Keys
O Registro do Windows tem chaves dedicadas a autostart. A diferença de escopo entre elas importa para quem investiga:
- HKCU…Run — não exige privilégio elevado, mas só dispara quando aquele usuário específico faz logon.
- HKLM…Run — exige privilégio administrativo para escrever, mas dispara para qualquer usuário que logar na máquina.
- RunOnce — mesma ideia de
Run, mas a entrada é removida pelo próprio Windows depois de executar uma vez.
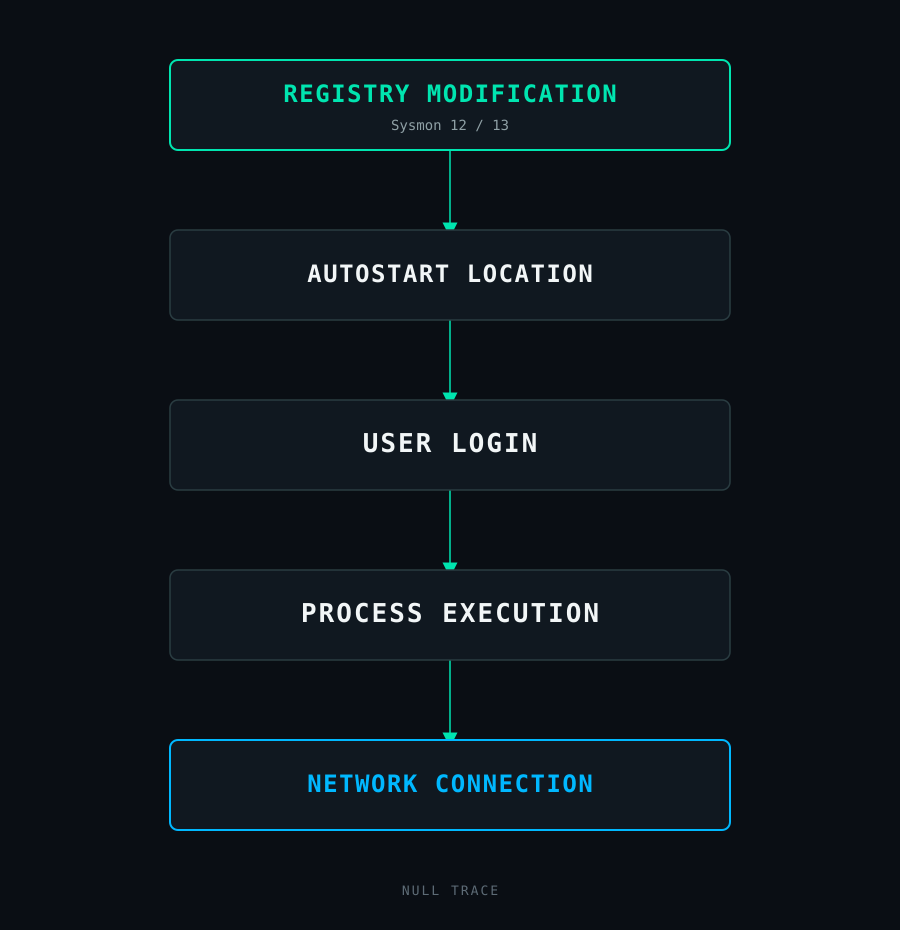
Detectando alterações no Registry
Sysmon separa esse tipo de evento em três Event IDs distintos: 12 (RegistryEvent, criação/exclusão de chave ou valor), 13 (RegistryEvent, valor definido — é este que captura o payload/caminho escrito na chave Run) e 14 (renomeação). Um EDR moderno costuma correlacionar isso automaticamente contra comportamento conhecido de autostart, mas mesmo sem EDR, um baseline do que é “normal” para as chaves Run/RunOnce de uma imagem padrão da organização já é suficiente para destacar entradas novas — comparar contra o que software legítimo costuma registrar ali é mais eficaz do que tentar decorar assinaturas de malware.
Windows Services como mecanismo de persistência
Um serviço registrado no Service Control Manager (SCM) pode ser configurado para iniciar automaticamente no boot, rodando sob a conta LocalSystem — privilégio equivalente a SYSTEM, o mais alto no host. Isso torna serviços um dos mecanismos de persistência mais atraentes do ponto de vista de privilégio, e um dos mais monitorados por quem já conhece a técnica.
O ponto relevante para investigação não é o SCM em si, mas a tripla que ele expõe: nome do serviço, executável associado e conta sob a qual roda. Um serviço legítimo tem essas três coisas coerentes entre si; um serviço criado para persistência costuma ter pelo menos uma delas destoando — caminho de binário fora de System32/Program Files, nome genérico sem DLL/executável correspondente instalado por nenhum produto conhecido.
NEW SERVICE
    ↓
UNKNOWN BINARY
    ↓
SYSTEM EXECUTION
    ↓
NETWORK CONNECTION
No log de Segurança, criação/instalação de serviço fica registrada no log System pelo próprio Service Control Manager (Event ID 7045, “A service was installed in the system”), com nome do serviço, caminho do binário e tipo de inicialização — o mesmo tipo de correlação usada para tarefas agendadas se aplica aqui: caminho gravável pelo usuário, nome sem instalador correspondente, e conexão de saída logo após o próximo boot.
Executáveis modificados como persistência
Em vez de criar um novo mecanismo de autostart, é possível alterar um binário legítimo já presente no sistema para que, toda vez que for aberto, também estabeleça C2 antes (ou depois) de rodar sua função original. O programa “backdoored” continua parecendo funcionar — é isso que torna a técnica perigosa do ponto de vista de integridade, não de furtividade absoluta.
Do lado defensivo, essa é uma das técnicas mais fáceis de detectar de forma sistemática, justamente porque altera algo que já existia: hash do arquivo muda em relação a uma baseline conhecida, assinatura digital deixa de bater (ou o binário deixa de estar assinado), e ferramentas de File Integrity Monitoring (FIM) disparam alerta na modificação. Comparar a versão instalada contra o hash publicado pelo fabricante — quando disponível — fecha a maior parte dos casos.
Persistência não é Credential Access
É comum ver esses conceitos tratados como uma coisa só num relato de pentest, mas o MITRE ATT&CK os separa por um motivo: são táticas diferentes, com objetivos diferentes, e misturá-los na hora de escrever uma detecção enfraquece a resposta.
PERSISTENCE
     ≠
CREDENTIAL ACCESS
     ≠
PRIVILEGE ESCALATION
     ≠
COMMAND AND CONTROL
O LSASS (Local Security Authority Subsystem Service) ilustra bem por que essa confusão acontece: depois que um usuário faz logon, o Windows guarda material de credencial na memória desse processo — é por isso que acessá-lo é um alvo tão comum em Credential Access (T1003.001, OS Credential Dumping: LSASS Memory). Mas dumpar LSASS não estabelece persistência nenhuma; é uma técnica completamente separada, usada tipicamente depois que algum mecanismo de persistência já garantiu que o operador consegue voltar ao host.
Do lado defensivo, o LSASS é exatamente o tipo de processo que se protege de forma dedicada — Credential Guard isola parte desse material de credencial num ambiente virtualizado inacessível mesmo a um processo rodando como SYSTEM, e a maioria dos EDRs modernos trata qualquer acesso de leitura ao LSASS por um processo não assinado/não esperado como sinal de alta severidade. Sysmon Event ID 10 (ProcessAccess) é a fonte de telemetria específica para isso: ele registra exatamente quando um processo abre outro, o caso de uso citado pela própria Microsoft sendo detectar ferramentas lendo a memória do LSASS. Um arquivo .dmp aparecendo em disco fora de um contexto de troubleshooting formal, ou uma ferramenta administrativa (como um utilitário de dump de processo) sendo usada contra o LSASS especificamente, também são indicadores fortes.
Contas locais como mecanismo de acesso persistente
Criar uma conta local nova, ou adicionar uma conta existente ao grupo Administrators, é uma forma de persistência que não depende de nenhum artefato em disco além do próprio SAM/AD — não há executável, não há tarefa agendada, não há chave de registro. Isso reduz a superfície de detecção baseada em arquivo, mas não elimina a telemetria: criação e alteração de conta são eventos de auditoria de segurança padrão do Windows.
O foco aqui é inteiramente detecção. Event ID 4720 (“A user account was created”) registra quem criou a conta, o nome da conta nova e uma série de atributos — contas locais criadas fora de um processo formal de provisionamento tendem a ter campos como Home Directory e Profile Path vazios, o que por si só já é um padrão a monitorar. Para adição a grupo privilegiado, Event ID 4732 (“A member was added to a security-enabled local group”) mostra exatamente quem foi adicionado, a qual grupo e por qual conta — monitorar esse evento especificamente para o grupo Administrators é uma das regras de maior custo-benefício em qualquer ambiente Windows.
RMM e ferramentas legítimas como mecanismo alternativo de acesso
Uma categoria à parte de persistência não depende de nenhum implant: instalar (ou abusar de uma instalação já existente) uma ferramenta de acesso remoto legítima — AnyDesk, TeamViewer, ou uma solução RMM corporativa como as citadas pelo próprio MITRE. O ATT&CK cataloga isso como Remote Access Tools (T1219, tática Command and Control), reconhecendo explicitamente que esse tipo de abuso de ferramenta confiável é um padrão comum o bastante para ter uma técnica dedicada.
O conceito por trás disso costuma ser chamado de living off trusted tools: o software em si não é malicioso, tem certificado válido, aparece em qualquer inventário — e é exatamente por isso que passa despercebido em ambientes sem controle de software instalado. A defesa não é técnica de detecção de malware, é gestão de superfície: inventário de software atualizado, allowlisting de aplicações (bloquear por padrão, liberar só o que é aprovado), monitoramento de novos processos/serviços de ferramentas de acesso remoto, e alertar sobre instalação desse tipo de software fora de uma política corporativa conhecida. Uma instalação de ferramenta de acesso remoto num host que nunca teve uma antes é, isoladamente, um evento que merece revisão.
Detectando persistência C2 no Windows
Reunindo as fontes de telemetria já citadas por tipo de mecanismo:
Windows Event Logs
4698 (tarefa agendada criada), 7045 (serviço instalado, log System), 4720 (conta criada) e 4732 (membro adicionado a grupo local) cobrem, juntos, a maior parte dos mecanismos discutidos neste artigo — e todos existem no Windows sem precisar instalar nada, desde que a política de auditoria correspondente esteja habilitada.
Sysmon
Process Creation (1), Network Connection (3), Process Access (10), File Creation (11), Registry Event (12/13/14) e DNS Query (22) cobrem o que os Event Logs nativos não capturam com o mesmo nível de detalhe — principalmente linha de comando completa do processo e a granularidade de qual valor específico de registro foi escrito.
EDR
A diferença de um EDR para os logs nativos não é “ver mais eventos”, é correlação comportamental automática — reconhecer que um processo criando uma tarefa agendada, gravando em System32 e abrindo uma conexão de saída na sequência é, junto, um padrão suspeito, mesmo que cada evento isolado pareça inofensivo.
Rede
Conexões periódicas para o mesmo destino, resolução DNS repetida para domínios pouco frequentados pelo resto da rede, certificados TLS emitidos recentemente ou auto-assinados, e — o padrão mais característico de beaconing — intervalo entre conexões consistente demais para ser tráfego humano normal.
Correlação: nenhum evento isolado é prova
Uma chave de registro nova, sozinha, pode ser um instalador legítimo. Um processo desconhecido, sozinho, pode ser uma ferramenta interna sem documentação. É a combinação de sinais, não um único evento, que sustenta uma detecção de alta confiança:
REGISTRY RUN KEY CREATED
          +
UNKNOWN EXECUTABLE
          +
PROCESS START
          +
OUTBOUND CONNECTION
          +
PERIODIC TRAFFIC
          ↓
HIGHER CONFIDENCE
Isso é o que separa threat hunting de simplesmente ligar todos os alertas de uma vez: cada fonte de telemetria sozinha tem alto índice de falso positivo, mas a interseção de várias, na mesma janela de tempo, no mesmo host, reduz drasticamente o espaço de investigação.
Persistência vs. Detecção — visão consolidada
O que um Red Team deve aprender com persistência
O objetivo desta seção não é evasão — é disciplina operacional. Todo mecanismo de persistência criado durante um engagement é uma mudança real no ambiente do cliente, e precisa ser tratado como tal: documentado no momento em que é criado (não de memória, no relatório final), com impacto avaliado antes de ser implantado, e com plano de rollback definido antes — não depois — de qualquer ação.
Ao final do engagement, cada mecanismo criado precisa ser removido: tarefa agendada deletada, chave de registro revertida, serviço desinstalado, conta local removida ou desativada. Um Red Team que deixa persistência ativa depois do exercício — mesmo sem intenção maliciosa — transformou um teste autorizado num risco real de segurança para o cliente. As regras de engajamento existem para evitar exatamente esse tipo de indisponibilidade ou exposição residual.
O que o Blue Team deve aprender
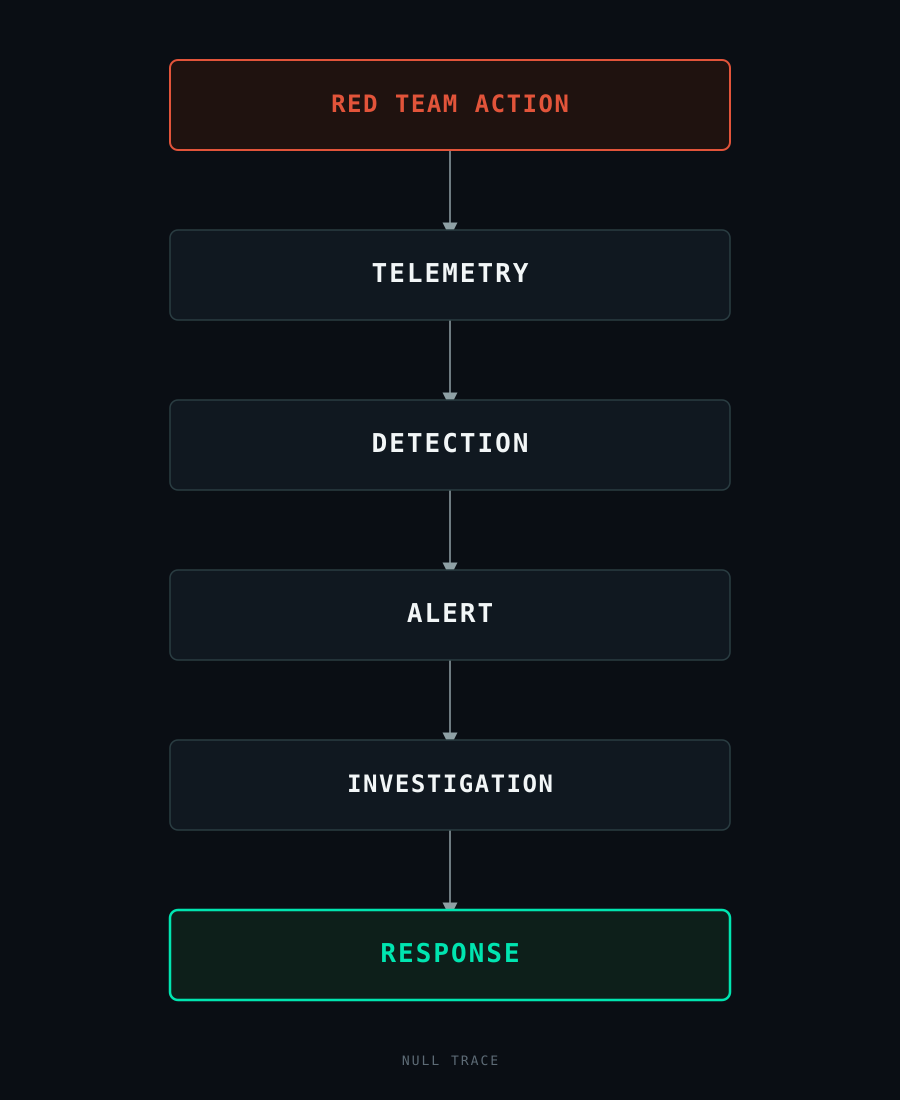
Estudar um framework de C2 em laboratório — inclusive gerar os próprios artefatos de persistência e observar exatamente o que cada um deixa — é uma das formas mais diretas de construir detecção com confiança real, em vez de copiar uma regra de SIEM de algum repositório sem entender o que ela cobre.
Cada seção deste artigo já mapeou o par técnica/telemetria que sustenta uma hunting query específica — Event ID 4698 com TaskContent contendo caminho fora de diretórios esperados, Sysmon 13 com valor de Run apontando para diretório gravável pelo usuário, Sysmon 10 com processo não assinado acessando lsass.exe. Um baseline de laboratório, gerado exatamente como neste artigo, é o material mais direto para calibrar essas queries antes de rodá-las contra produção.
Quem quiser aprofundar a caça a persistência do lado puramente defensivo, com ferramentas de PowerShell dedicadas a essa triagem, pode conferir PowerShell para DFIR — Parte 2: Encontrando Persistência no Windows, publicado anteriormente aqui no Null Trace — este artigo cobre o mesmo conjunto de técnicas a partir do lado ofensivo, mapeado a um framework de C2 real e ao MITRE ATT&CK.