Como transformar o ruído de alertas Wazuh em inteligência acionável: arquitetura em camadas com Haiku para triagem e Opus para análise profunda, enriquecimento keyless, deduplicação por alert ID, relatórios HTML automatizados, e custo de centavos por semana.
Introdução: O Problema Não Era Detectar, Era Separar o Sinal do Ruído
Opero uma pequena frota de VPSs OVH e um host de monitoramento on-prem. Dei ao Wazuh outra chance para logging de segurança da frota — single-node, tailnet-bound, deliberadamente contido. Funciona. Mas também faz o que todo SIEM faz: gera muito mais sinal do que uma equipe de uma pessoa consegue ler.
Quis conhecer a forma real do problema antes de automatizar qualquer coisa, então perguntei ao indexer uma pergunta direta: quantos alertas nível 10+ caíram em um dia, e quais regras os produziram.
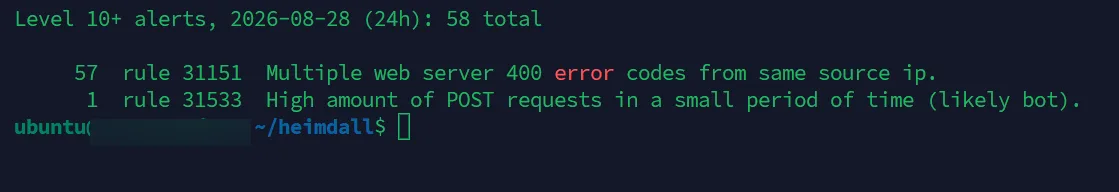
Cinquenta e oito alertas. Cinquenta e sete deles eram uma única regra: 31151, “Multiple web server 400 error codes from same source ip.” Bots martelando /function.php e similares em uma box pública. Um único alerta, regra 31533, era o outlier real que merecia atenção humana.
Essa proporção é a história toda. O problema de engenharia interessante aqui nunca foi “um LLM consegue ler um alerta Wazuh.” Claro que consegue. O problema é que se você apontar um modelo para o firehose bruto, você paga para ele raciocinar sobre 57 pedaços de ruído para achar o único que importa, e o ruído afoga o sinal no contexto dele. O ganho está no que você faz _antes_ da chamada ao modelo.
Figura 1. Cabeçalho da implementação original: Operation Night Shift — analista LLM para Wazuh que roda 4x/dia por centavos.Figura 2. Query Elasticsearch: 58 alertas nível 10+ em 24h. 57 da regra 31151 (Multiple web server 400 error codes from same source ip — bots em /function.php). 1 da regra 31533 (outlier real). Ratio 57:1.
Arquitetura Errada vs Certa: Pipeline em Camadas
A construção ingênua é por alerta: cada alerta qualificado dispara uma chamada profunda ao modelo que raciocina sobre ele e escreve um veredito. É simples, é event-driven, e é a escolha errada — pelo menos para o meu caso e cenário. Para um SOC Agentic, seria outra história completamente diferente. Para mim, preciso vigiar o $$$ — quebra batching, estampa no momento em que uma campanha de spray começa, e gasta seu modelo mais caro nos eventos menos interessantes.
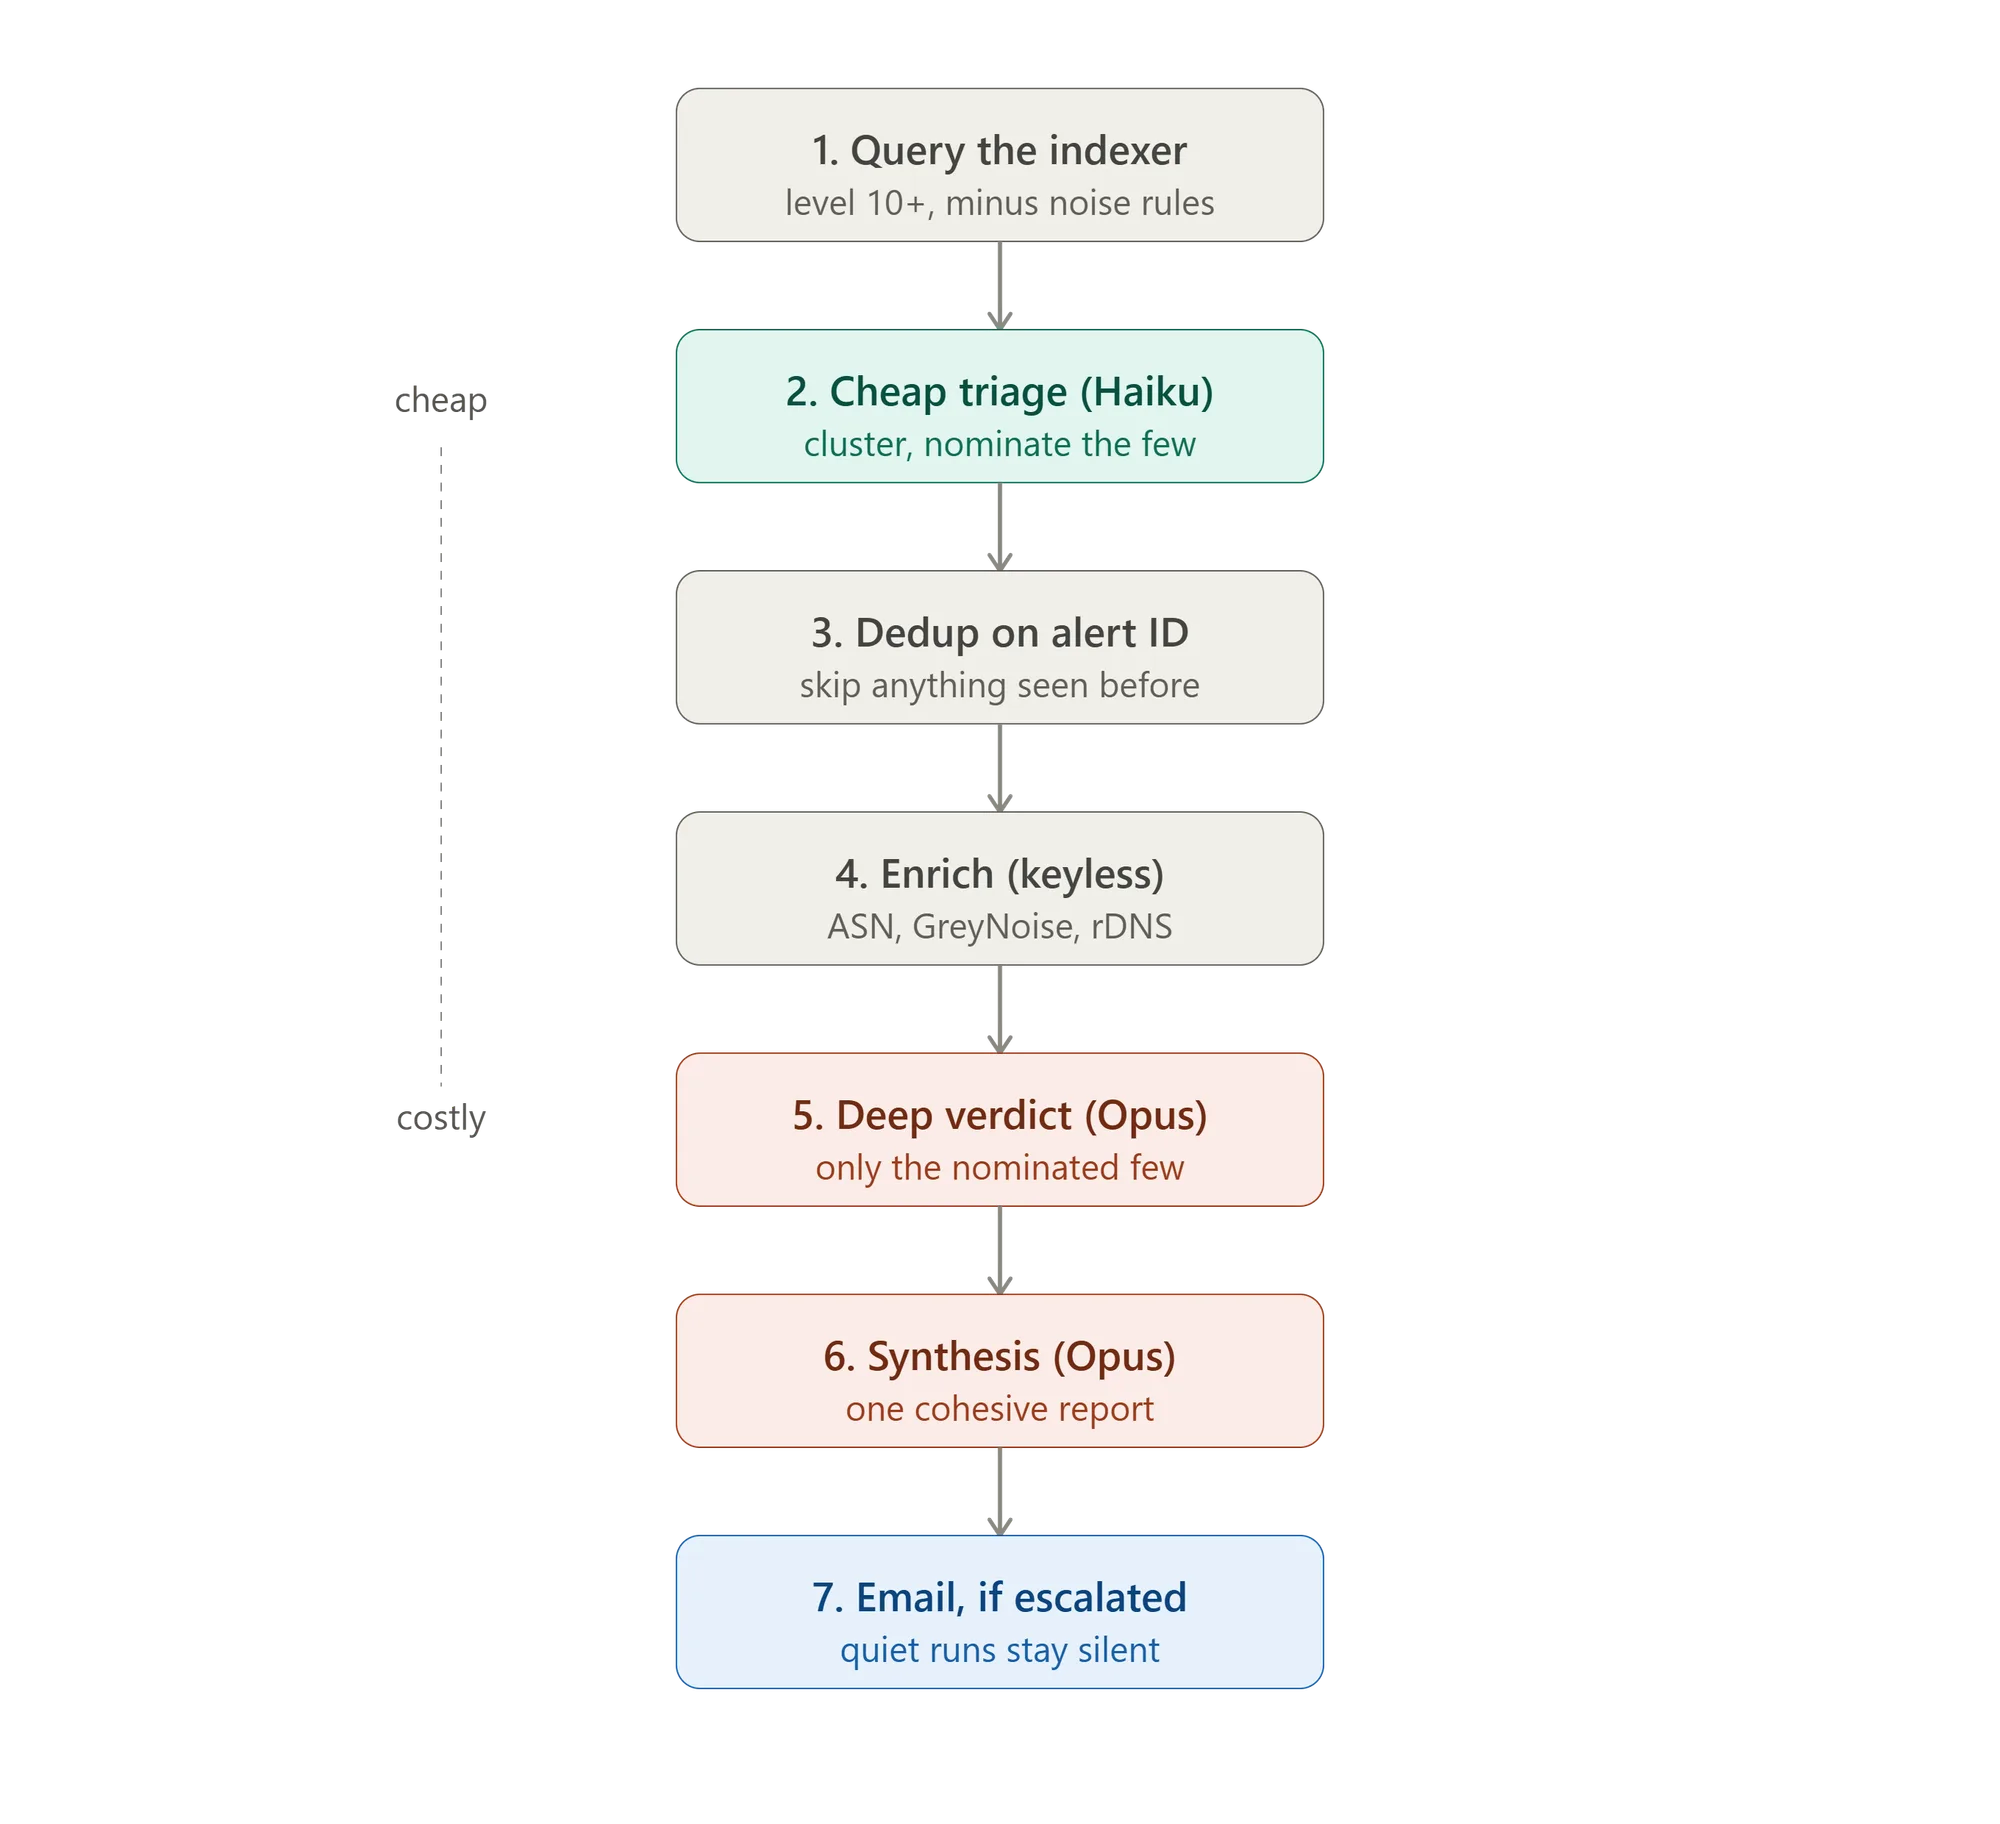
O que realmente funciona é um tier (camada):
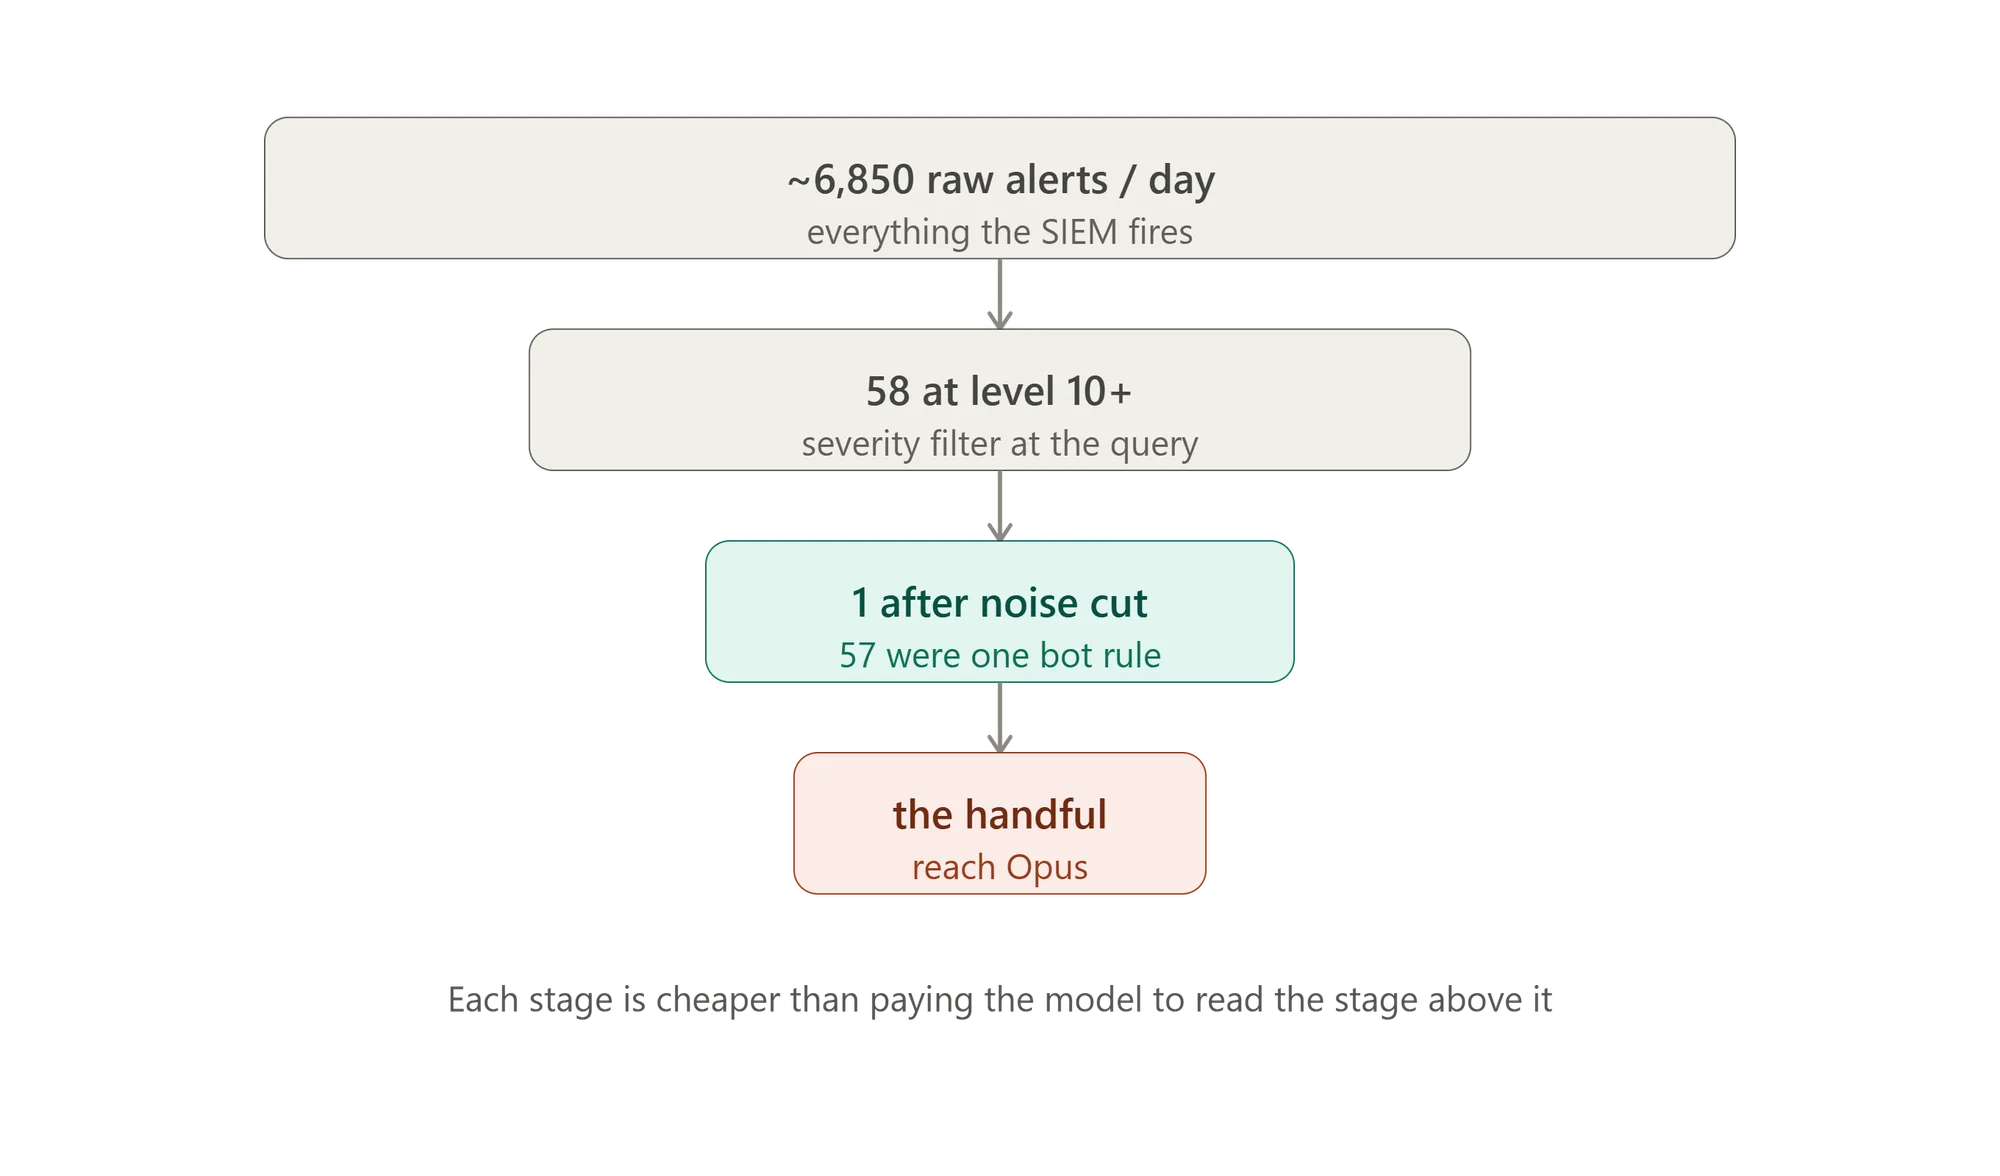
Filtre na query. Puxe nível 10+, exclua os rule IDs de ruído conhecidos. Isso é grátis e é onde 90% do volume morre.
Passe de triagem barato. Entregue o conjunto filtrado inteiro a um modelo rápido e barato (Haiku) em uma única chamada. Peça para ele agrupar alertas relacionados e nomear os poucos que merecem profundidade. Isso é trabalho de extração e Haiku é bom nisso.
Profundidade cara, parcimoniosamente. Só o punhado nomeado vai para o modelo forte (Opus) para um veredito real, que lê como um achado em relatório.
Síntese. Mais uma chamada ao modelo forte pega os vereditos e escreve um único relatório coeso, não uma pilha de parágrafos desconectados.
Entregue. Renderize para HTML estilizado, envie por e-mail, mas só quando algo novo realmente escalou.
A alavanca de custo está inteiramente na etapa 3: quantos alertas chegam ao modelo caro. Tudo antes disso existe para fazer esse número pequeno e correto.
Figura 3. Funil de volume: query bruta traz ruído massivo; filtro na query remove noise rules conhecidos; Haiku faz triagem barata; apenas poucos chegam ao Opus caro. 90% do volume morre no filtro gratuito.Figura 4. Pipeline em 5 etapas: 1) Filter at Query (exclui noise rules) 2) Cheap Triage Pass (Haiku, clustering + nomeação) 3) Expensive Depth (Opus, veredito profundo) 4) Synthesis (relatório coeso) 5) Deliver (só se escalou). Custo concentrado na etapa 3.
Onde Roda: Heimdall, Tailscale e Credenciais Read-Only
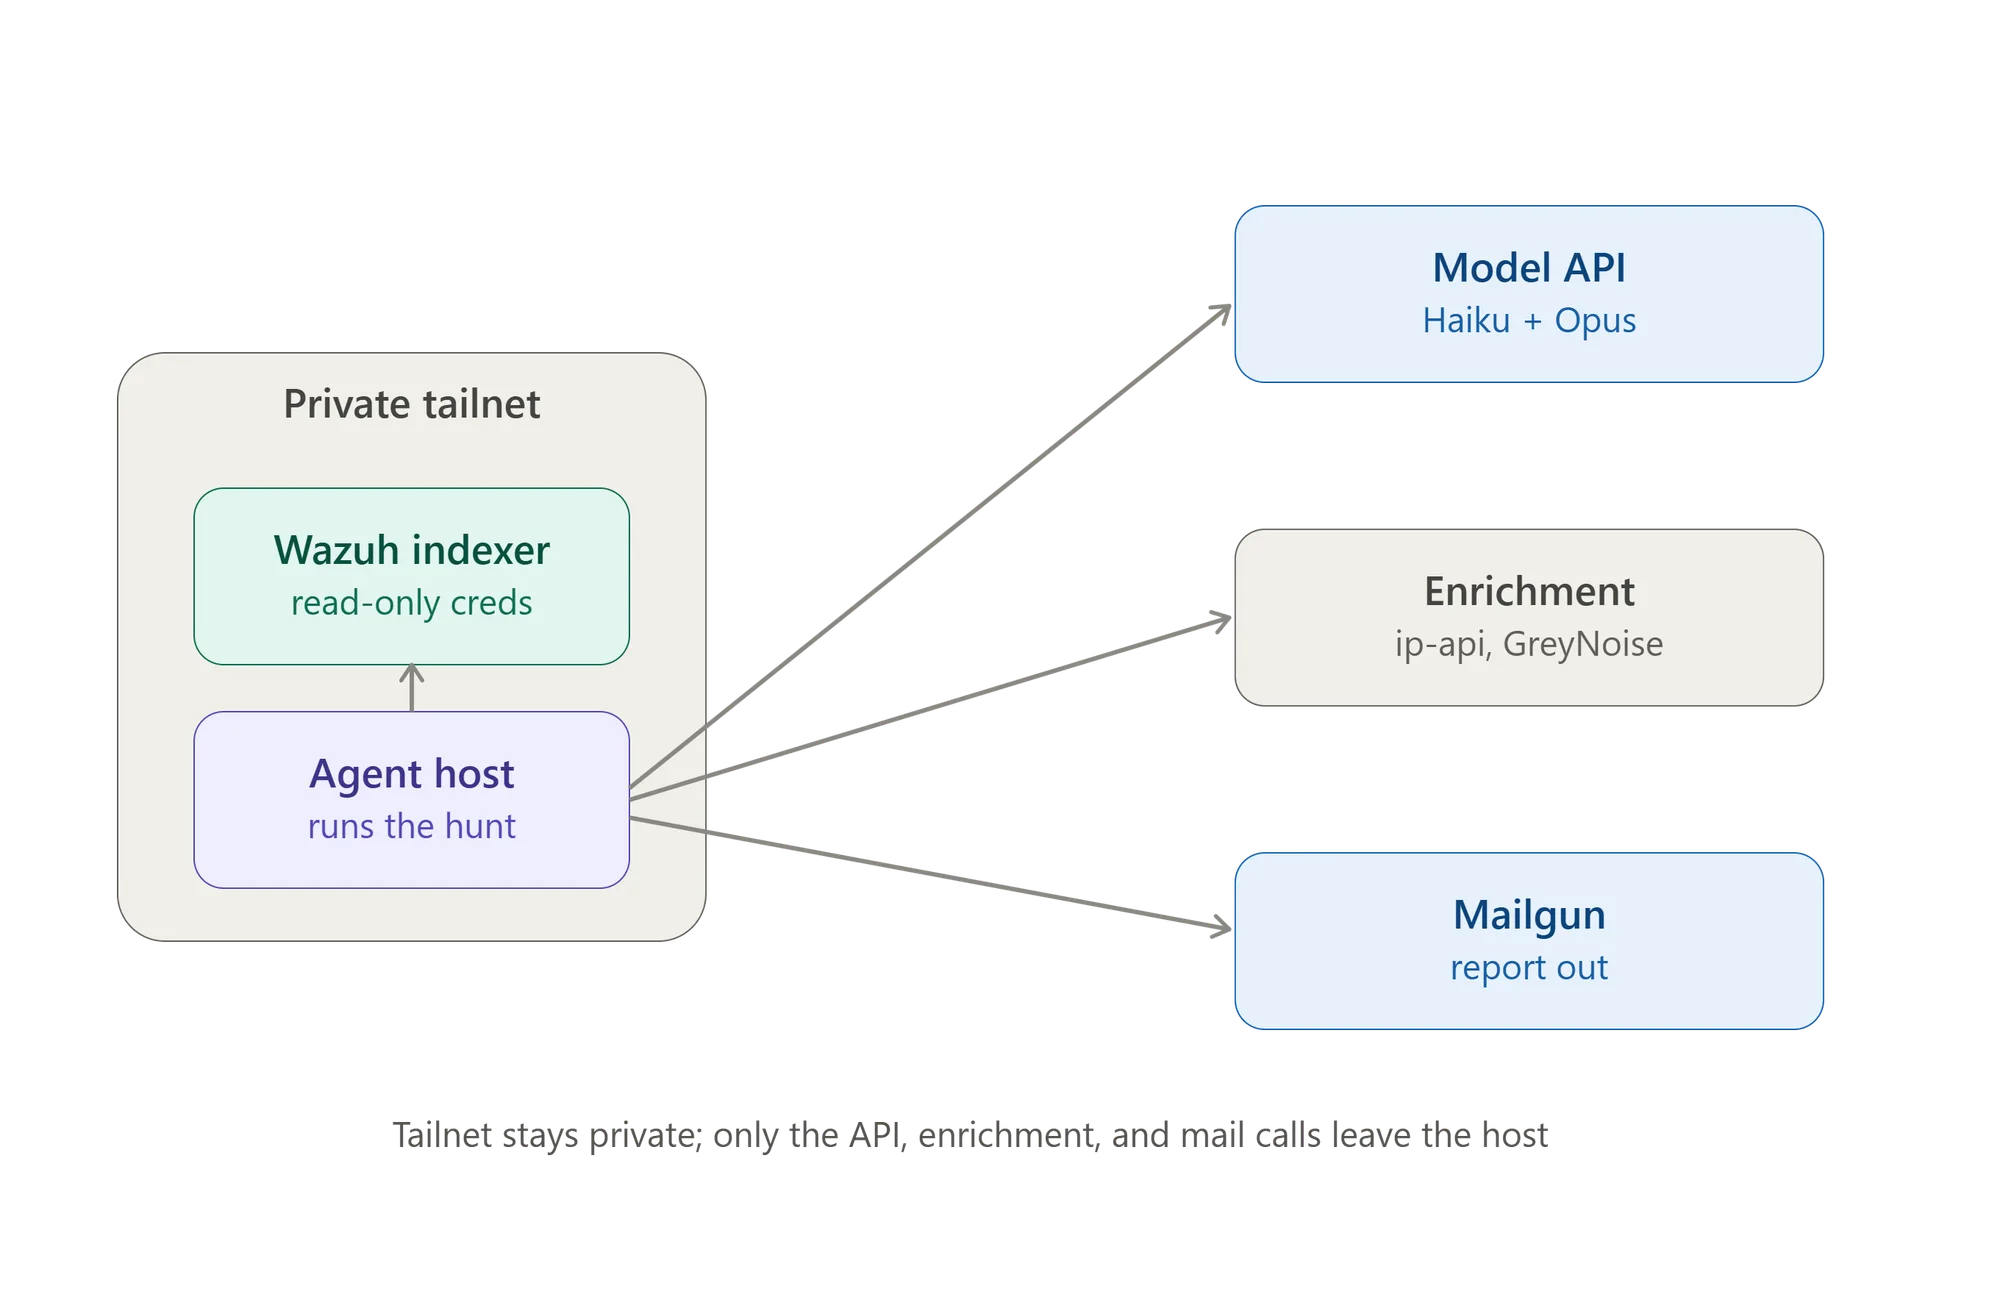
Já tinha um host de agente endurecido, uma box OVH que chamo de Heimdall, rodando o agente Hermes para um brief de notícias entregue via Signal. Rootless Docker, Cloudflare Access no dashboard, egress-guarded. Já guardava uma chave Anthropic e já falava com minha tailnet. Isso o tornava a casa óbvia para isso: consegue alcançar o indexer Wazuh pela tailnet e consegue alcançar a API, e tudo é raio de explosão de uma box só.
Duas peças de acesso tiveram que existir primeiro.
Uma credencial Wazuh read-only. Não admin. Nas configurações de segurança do indexer criei um role escopo read no índice wazuh-alerts-* e nada mais, mapeei para um usuário interno dedicado, e guardei num env file no Heimdall. Se a conta de hunt vazar, lê alertas e não faz mais nada.
Um indexer alcançável. Fora da caixa, o Wazuh single-node compose publica o indexer em 127.0.0.1:9200 apenas. Heimdall é outra box, então dava connection-refused até eu bindar a porta ao endereço tailnet no compose file e deixar uma ACL Tailscale escopar quem pode alcançar. Se você não copiar nada mais deste post, copie o instinto de checar em que porta algo está realmente bindado antes de culpar o cliente.
Figura 5. Topologia: Heimdall (OVH VPS, rootless Docker, Hermes agent) acessa Wazuh indexer via Tailscale (bind na tailnet address, não 127.0.0.1), chama Anthropic API, entrega via Mailgun. Credencial Wazuh read-only em role `read` no índice `wazuh-alerts-*`.
Enriquecimento Keyless: ip-api, GreyNoise, PTR
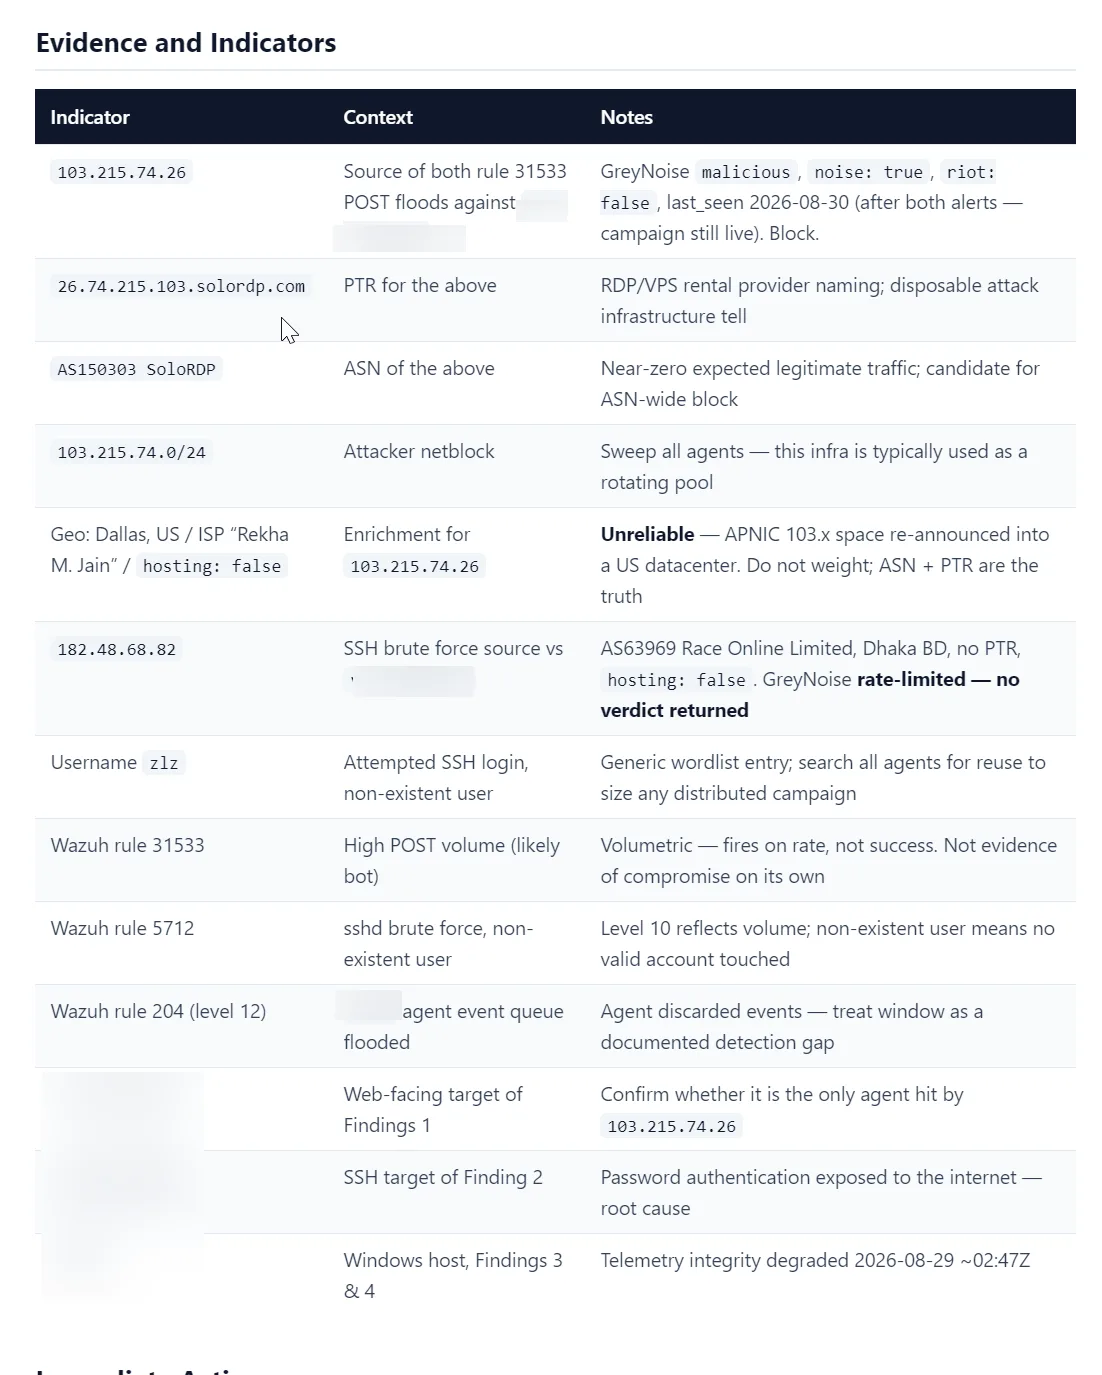
Um veredito só é tão afiado quanto seu contexto. Um alerta que diz “POST burst from 103.215.74.26” é quase inútil; o mesmo alerta com “AS150303 SoloRDP, GreyNoise says noise:true classification:malicious, PTR resolves to solordp.com” escreve sua própria conclusão.
Você não precisa de feeds pagos para o primeiro corte. Três fontes keyless cobrem a maior parte:
ip-api.com para ASN, org, geo, e hosting flag.
GreyNoise Community API (não autenticada, rate-limited mas fina para algumas lookups por run) para o campo mais útil em triagem: este IP está mass-scanning a Internet inteira, ou te alvejando.
Reverse DNS via PTR lookup simples.
A armadilha real: valide que cada resposta é JSON antes de passá-la a uma ferramenta JSON. Se uma fonte dá timeout ou retorna string de rate-limit e você passa direto para jq --argjson, a montagem inteira falha e você ganha um objeto de enriquecimento vazio. Guarde cada fonte independentemente para que uma resposta ruim não apague as outras:
Aprendi essa na marra: duas runs completas onde todo enriquecimento voltou vazio e todo veredito teve que fazer hedge com “unenriched, cannot be dismissed as benign.” As fontes funcionavam bem manualmente. A função estava engolindo elas. Guardar cada fonte consertou, e a run seguinte corretamente chamou aquele IP de POST-flooding de malicioso com o ASN pra confirmar.
Nunca Analise o Mesmo Alerta Duas Vezes
Se o job roda a cada seis horas, um alerta que cruza a fronteira da janela não deve ser re-analisado e re-cobrado. A regra que eu queria era simples e estrita: um alert ID, uma análise profunda, nunca. Mesma regra disparando de um evento fresco é um alerta novo e vale ver; o mesmo alert ID já era.
O Wazuh dá a cada alerta um _id de documento estável no indexer. Essa é a chave de dedup. Mantenha um arquivo plano de IDs que já receberam veredito, pule qualquer um nele, e adicione imediatamente após cada veredito para que um crash no meio da run no pior caso repita um alerta em vez do conjunto inteiro. A dedup acontece no passo de escalada (Opus), não na triagem (Haiku), então o modelo de triagem ainda vê a janela completa e agrupa corretamente; é só a chamada cara que é gated.
Modelos: Haiku 4.5 (Triage) + Opus 5 (Deep + Síntese)
Usei dois modelos diretamente pela Messages API. Haiku 4.5 (claude-haiku-4-5-20251001) para triagem, Opus 5 (claude-opus-5) para vereditos profundos e síntese. No momento da escrita, Haiku custa $1/$5 por milhão de tokens in/out, Opus $5/$25, a Batch API divide ambos por 2, e leituras de cached input custam um décimo do preço. Verifique taxas atuais antes de ir, elas mudam.
Uma varredura completa de sete dias do meu ambiente atual no escopo deste projeto, três alertas escalados ao Opus, custaram dezoito centavos. Opus foi 99% disso. Haiku triagem sobre o conjunto inteiro custou menos de um quinto de centavo. O headline honesto: frequência de runs mal afeta custo, porque custo é função de quantos alertas distintos recebem veredito profundo, não de quantas vezes você olha. Rode a cada hora se quiser; você ainda só paga para analisar cada alerta uma vez.
A instrumentação importa tanto quanto o gasto. Cada chamada ao modelo imprime seus token counts e um total acumulado, então o log te diz exatamente o que uma run custou. Quando um relatório truncou no meio da seção, o log mostrou a chamada de síntese batendo no teto de tokens, fix de um número, não um mistério.
O Relatório: Estrutura, Renderização e Entrega
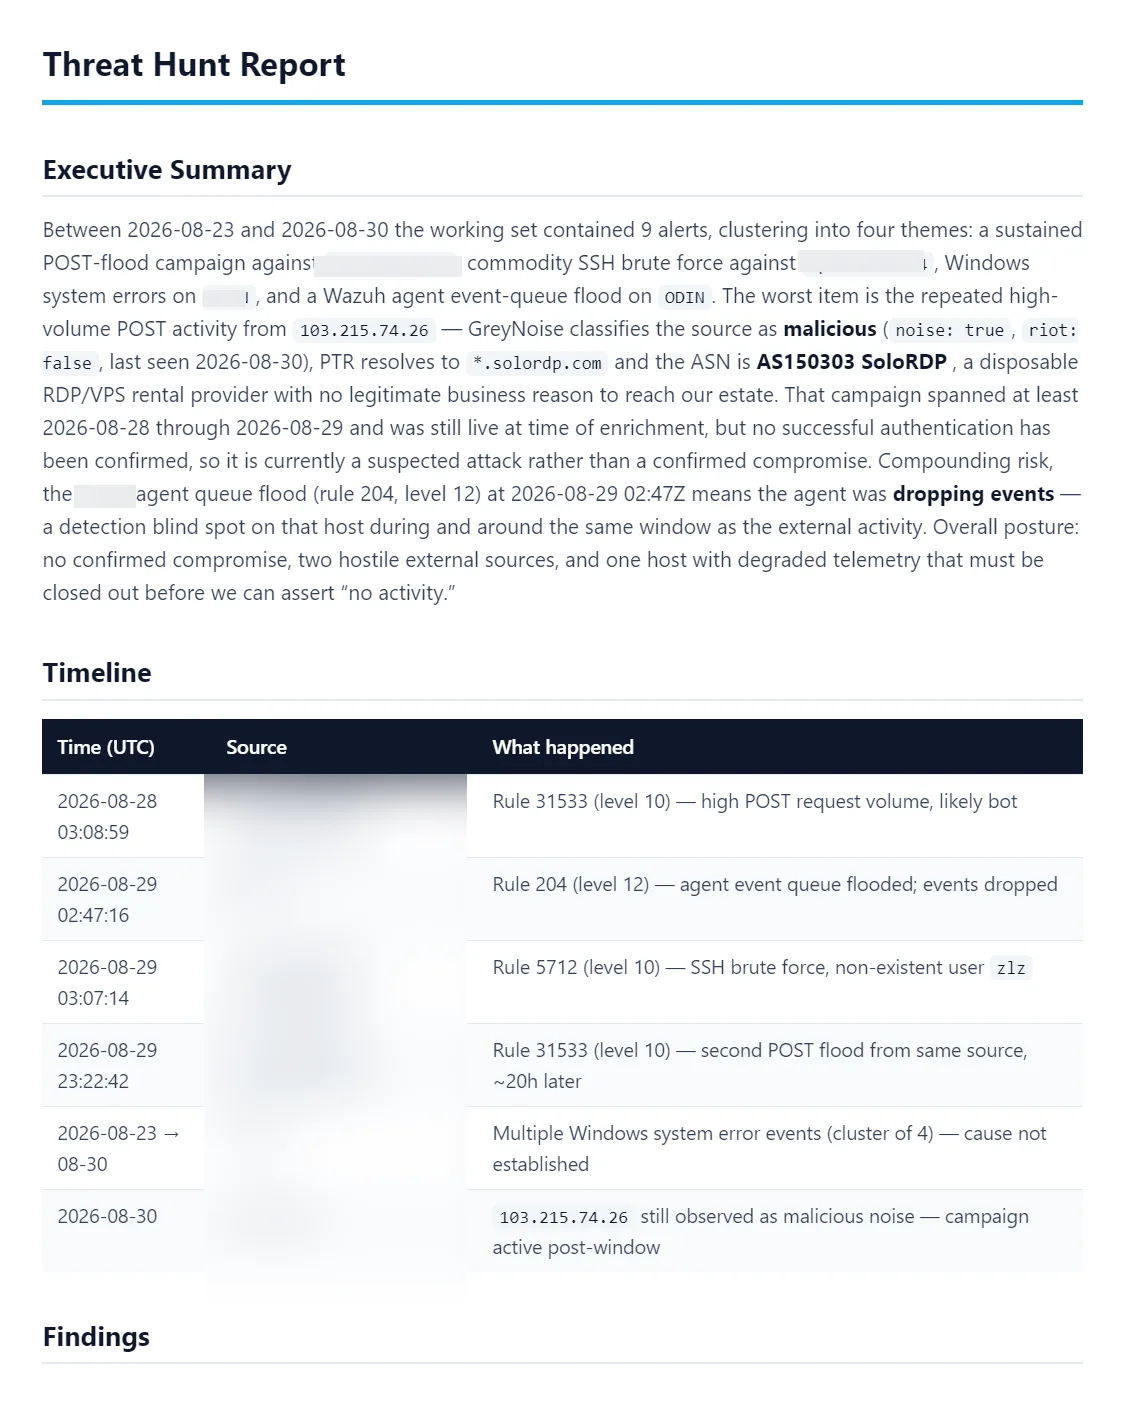
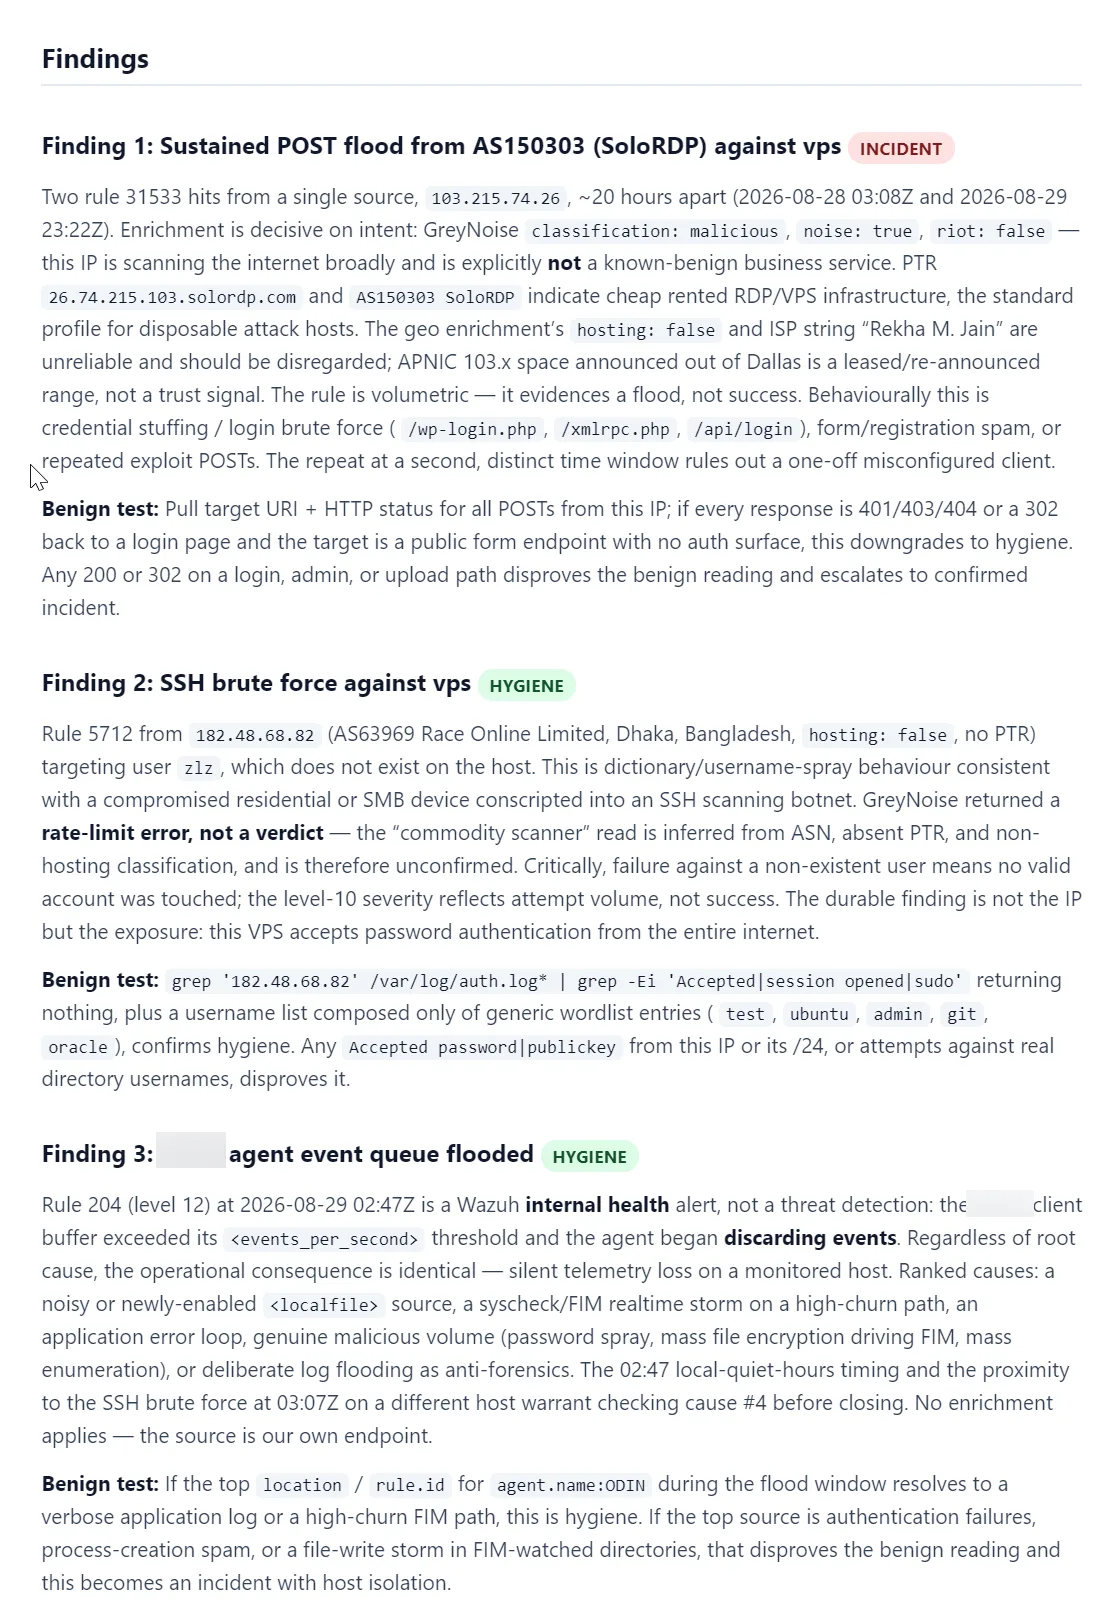
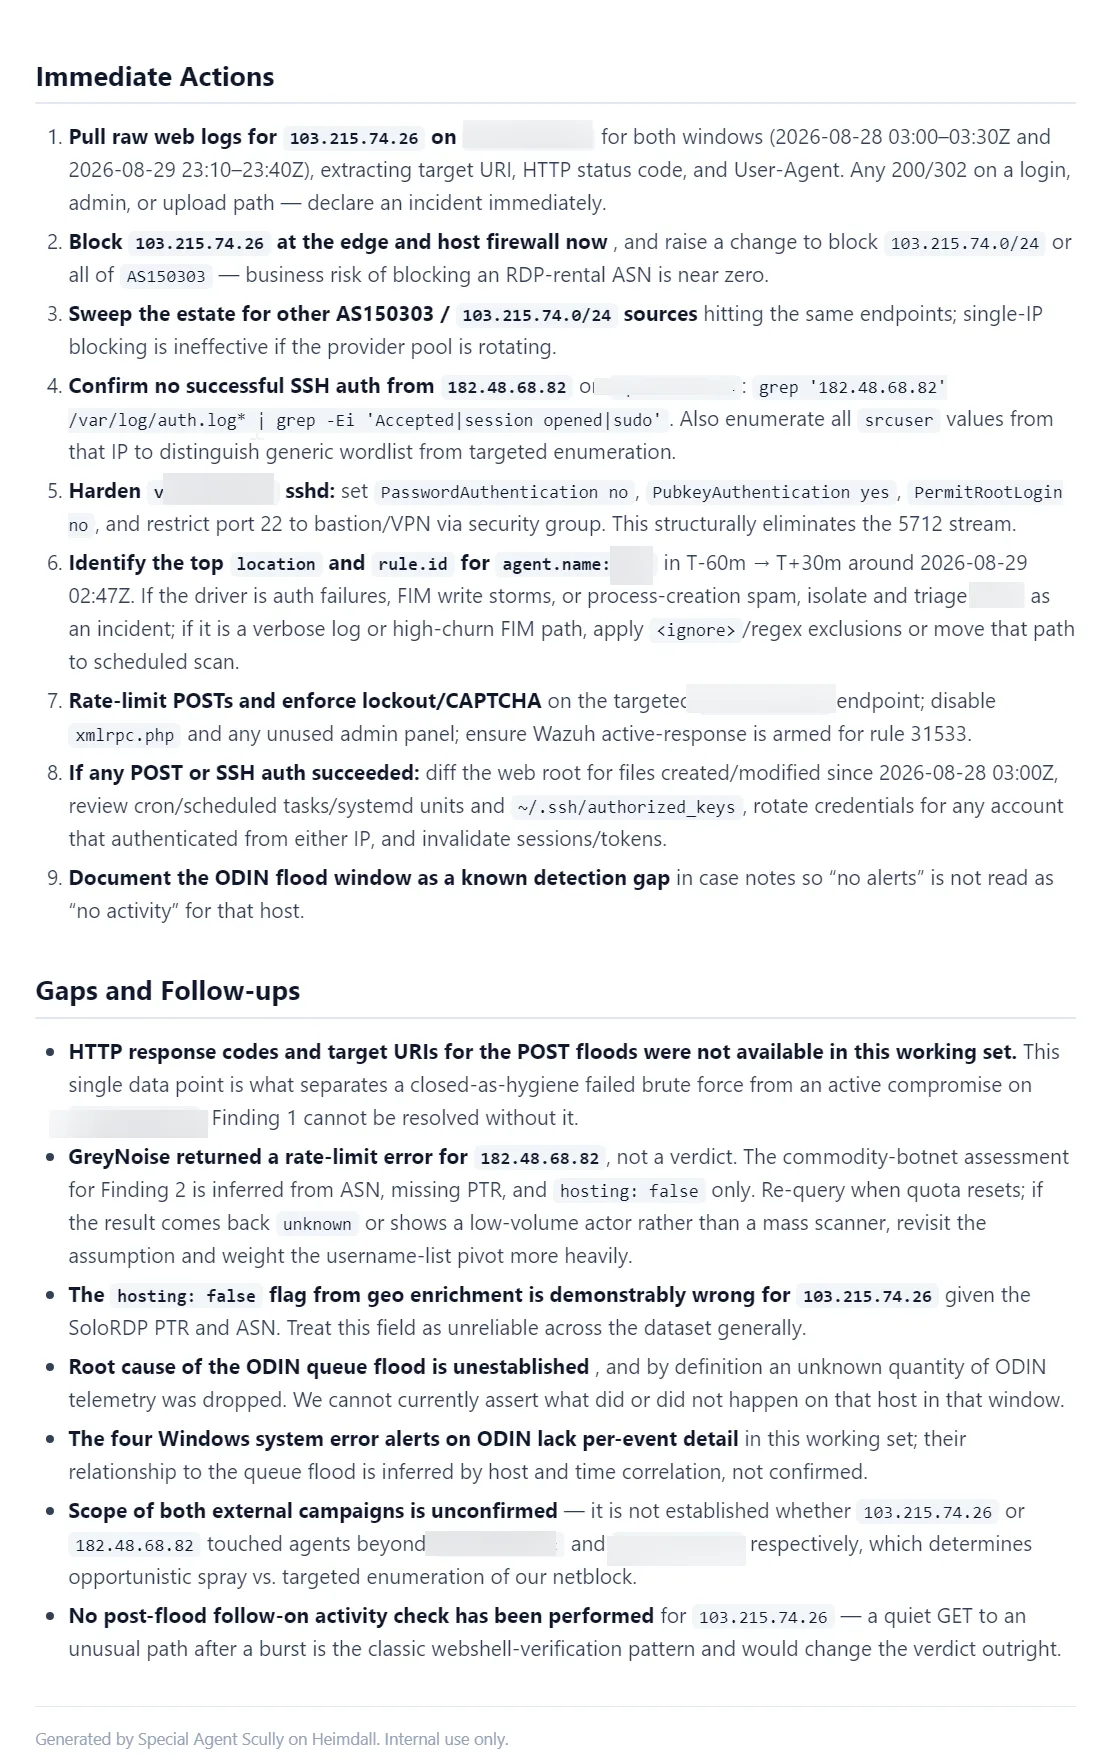
O prompt de síntese fixa uma estrutura de casa para que todo relatório leia igual: executive summary, timeline, findings cada um carregando um verdict label e um “benign test” de uma linha dizendo o que disprovaria a leitura maliciosa, uma evidence table, immediate actions, e uma gaps section que diz francamente o que não pôde ser confirmado. Essa última parte é o que torna confiável. Um analista que nunca admite incerteza não é um que você mantém.
Depois renderiza. Pandoc vira o markdown em HTML, um pequeno styler injeta CSS inline (e-mail clients ignoram external stylesheets), e o resultado é um card restrito com verdict badges color-coded, dark-header tables, e monospace para IPs e rule IDs. Sai via Mailgun, de um sender que chamei Special Agent Scully, porque se uma máquina vai me mandar avaliações de ameaça às 3 da manhã, que pelo menos tenha um nome. Só envia quando algo novo escalou; ciclos silenciosos ficam silenciosos para a inbox continuar significando algo.
Uma quirk vale saber se você constrói o styler com regex:
]*> casa feliz com
, porque “thead” começa com “th”. Isso mangulhou todo header de tabela que gerei até eu fazer o pattern recusar match com thead. Caseie contra o que seu renderer *realmente* emite, não o que você assume que emite.
Figura 6. Relatório HTML (parte 1): executive summary, timeline, findings com verdict badges coloridos, evidence table, immediate actions, gaps section. Pandoc markdown→HTML, CSS inline para e-mail clients, Mailgun delivery. Sender: ‘Special Agent Scully’.Figura 7. Relatório HTML (parte 2): findings detalhados com verdict label, benign test (o que disprova leitura maliciosa), evidence table com IPs, rule IDs, enrichment data (ASN, GreyNoise, PTR).Figura 8. Relatório HTML (parte 3): gaps section — admite claramente o que não pôde ser confirmado. ‘An analyst who never admits uncertainty is not one you keep.’Figura 9. Relatório HTML (parte 4): e-mail completo com header escuro, tabelas dark-header, monospace para IPs e rule IDs, verdict badges coloridos. CSS inline injetado (e-mail clients ignoram external stylesheets).
Resultados Reais: 7 Dias, 3 Escalonamentos, $0.18
Sete dias de execução do meu ambiente atual no escopo deste projeto: três alertas escalados ao Opus. Custo total $0.18 (Opus 99%). Haiku triagem sobre o conjunto inteiro menos de um quinto de centavo. Os token counts são instrumentados em cada chamada ao modelo, então o log te diz exatamente o que uma run custou. Quando um relatório truncou no meio da seção, o log mostrou a chamada de síntese batendo no teto de tokens, fix de um número, não um mistério.
A qualidade do relatório: verdict labels, benign test (o que disprova leitura maliciosa), evidence table, immediate actions, gaps section que admite incerteza. Essa última parte é o que torna confiável — um analista que nunca admite incerteza não é um que você mantém.
Figura 10. Relatório HTML (parte 1): executive summary, timeline, findings com verdict badges coloridos, evidence table, immediate actions, gaps section. Pandoc markdown→HTML, CSS inline para e-mail clients, Mailgun delivery.
Agendamento, Custos e Lições Operacionais
Uma entrada cron a cada seis horas, rodando como o usuário que possui os env files, com a janela de consulta travada no intervalo para que cada alerta caia em exatamente uma janela:
A linha PATH não é opcional. Cron roda com environment strippado e não vai achar jq, pandoc, dig, ou python3 do jeito que seu login shell faz. Teste do jeito que cron vai rodar, com env -i, antes de confiar:
Só envie quando escalou — inbox silencioso mantém significado.
Segurança e Privacidade: Logs Sensíveis em LLM Externo
Um ponto arquitetural crítico: alertas de segurança contêm informações sensíveis. Nomes de usuários, IPs internos, hostnames, comandos executados, caminhos de arquivos, eventos de autenticação, detalhes de infraestrutura. Ao enviar eventos para um LLM externo (API Anthropic no caso), uma organização precisa avaliar:
Dados pessoais (PII) nos logs
Nomes de usuários e credenciais parciais
IPs internos e topologia de rede
Hostnames e nomenclatura de ativos
Comandos executados e caminhos de arquivos
Eventos de autenticação e falhas
Políticas de retenção do provedor (Anthropic)
Jurisdição e conformidade (LGPD, GDPR, etc.)
A implementação original usa a API Anthropic Messages diretamente. Não há afirmação de vazamento no projeto original — isso é tratado como consideração arquitetural e operacional que cada organização deve fazer antes de adotar. Estratégias possíveis: sanitização prévia de campos sensíveis, uso de modelos locais (ex: via Ollama), ou acordos de processamento de dados com o provedor.
Conclusão: IA Auxilia, Não Substitui o Analista
Os alertas nunca param. Agora, nem a leitura.
O Operation Night Shift demonstra que uma arquitetura tiered (em camadas) resolve o problema de custo e ruído: filtro gratuito na query mata 90% do volume, Haiku barato faz triagem e clustering no que sobra, Opus caro só analisa o punhado que realmente merece, e uma síntese forte entrega um relatório coeso — não uma pilha de parágrafos.
A IA auxilia o analista SOC. Não substitui.
Falsos positivos, falsos negativos, alucinação, ausência de contexto, qualidade variável dos logs — tudo isso exige revisão humana. O próprio relatório inclui uma gaps section admitindo incerteza; um analista que nunca admite incerteza não é confiável.
A automação lê 57 ruídos para encontrar 1 sinal. O humano decide o que fazer com o sinal.
Custo operacional: centavos por semana. Frequência: quatro vezes ao dia. Cobertura: contínua, enquanto você dorme.
A engenharia social explora vulnerabilidades psicológicas humanas para obter acesso não autorizado a sistemas e informações, sendo um componente crítico nos testes de penetração.
engenharia social · psicologia · segurança ofensiva
O ADStrike automatiza o pentest de Active Directory com 52 módulos de ataque e um orquestrador de IA opcional, cobrindo reconhecimento, Kerberoasting, Timeroasting, Pre2k…