NT-2026.09.26 DOSSIÊ PENTEST
KATANA: CRAWLING E SPIDERING DE APLICAÇÕES WEB MODERNAS
Como o Katana mapeia aplicações web modernas e single-page applications: instalação via Go, Standard e Headless Mode, crawling de apps JavaScript-heavy com -js-crawl, descoberta de robots.txt e sitemap.xml com -known-files e filtros de saída por campo, extensão e regex.
O que é o Katana
Mapear, percorrer (crawling) e indexar (spidering) uma aplicação web com eficácia pode significar a diferença entre um engagement bem-sucedido e a perda de vulnerabilidades críticas para toda uma organização. O problema central aparece quando o alvo é uma SPA, ou single-page application: o site carrega um único arquivo HTML e atualiza o conteúdo dinamicamente conforme o usuário interage. Ferramentas de crawling tradicionais, desenhadas para aplicações de renderização no servidor e HTML estático, tornam-se inefazes diante desse cenário.
O Katana é um framework de crawling e spidering de nova geração, desenvolvido pelos pesquisadores da ProjectDiscovery. Trata-se de um crawler rápido, modular e com suporte a múltiplas técnicas de varredura, criado para descobrir caminhos, parâmetros e endpoints ocultos em aplicações web — inclusive naquelas construídas sobre frameworks JavaScript modernos e mecanismos de autenticação sofisticados.
O diferencial mais impressionante é o tratamento de execução de JavaScript e renderização de conteúdo dinâmico. Crawlers tradicionais perdem funcionalidade crítica porque não executam JavaScript nem compreendem como as aplicações modernas geram conteúdo dinamicamente. O Katana incorpora capacidades de navegador headless que renderizam páginas por completo, executam JavaScript e revelam conteúdo que de outra forma permaneceria oculto.
Este artigo percorre o download, a instalação e a utilização da ferramenta para elevar sua capacidade de reconhecimento em testes de segurança de aplicações web.
Instalação
Há alguns métodos de instalação; este artigo foca na instalação usando a linguagem de programação Go, o caminho documentado pelo projeto. São três etapas: verificar o pré-requisito, compilar a ferramenta e confirmar o resultado.
Verificando o Go
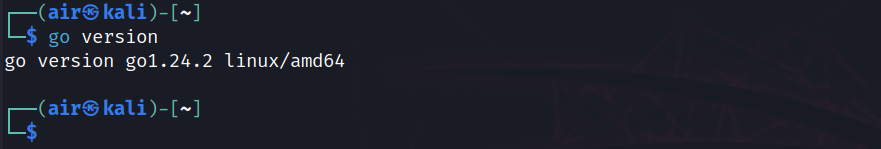
Primeiro, verifique se o Go já está instalado:
go versionA captura da demonstração de referência mostra o Go 1.24.2 em um Kali Linux — o README oficial do projeto recomenda usar a versão mais recente disponível do Go.
Compilando com go install
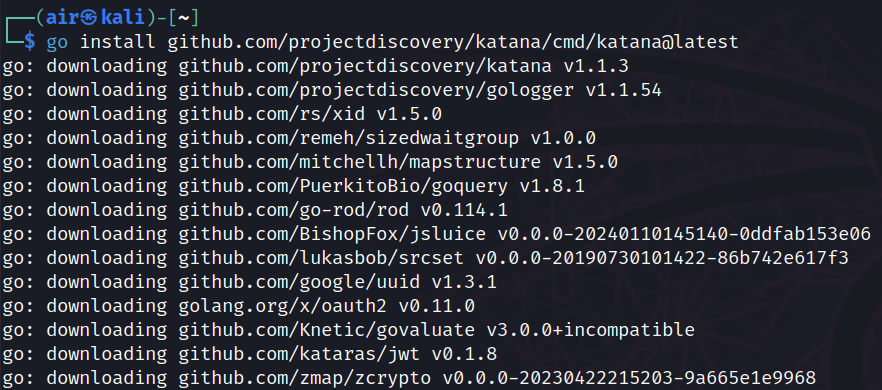
Instale o Katana pelo gerenciador de pacotes do Go:
go install github.com/projectdiscovery/katana/cmd/katana@latestO go install baixa o código do módulo e todas as dependências (gologger, goquery, go-rod, jsluice, entre outras) e compila o binário katana, deixando-o no diretório de binários do Go ($GOPATH/bin ou $HOME/go/bin).
Confirmando o binário
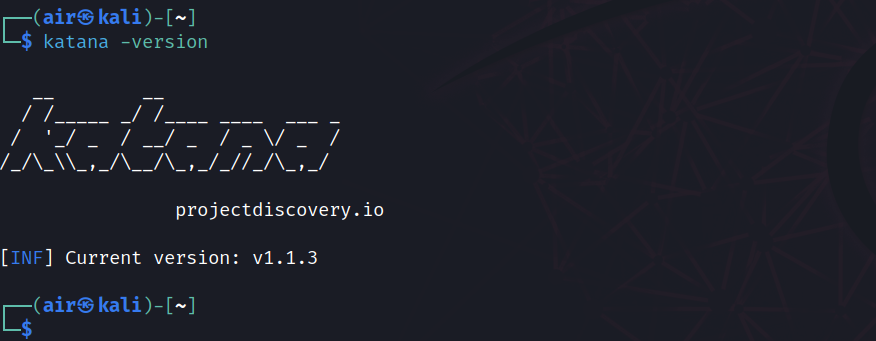
Verifique a instalação:
katana -versionA resposta da demonstração — Current version: v1.1.3 — confirma o binário no PATH e pronto para uso.
Modos de crawling
O Katana suporta dois modos principais de crawling, cada um adequado a um tipo de aplicação e caso de uso.
Standard Mode. Projetado para velocidade e simplicidade, ideal para sites tradicionais. Usa a biblioteca HTTP nativa do Go para tratar requisições e respostas, analisando o corpo bruto da resposta HTTP sem executar JavaScript ou renderizar o DOM. Essa abordagem leve garante desempenho rápido, mas pode perder endpoints em aplicações mais complexas que dependem de eventos do navegador.
Headless Mode. Oferece um crawling mais completo ao simular um ambiente de navegador real. É especialmente útil para aplicações modernas com muito JavaScript, pois captura tanto o conteúdo bruto quanto o renderizado. Ao imitar a impressão digital de um navegador legítimo — incluindo TLS e cabeçalhos user-agent —, melhora a cobertura e a detecção de elementos dinâmicos. Na terminologia do README oficial, é um crawling híbrido: os endpoints são descobertos analisando a resposta bruta padrão e também a resposta renderizada pelo navegador, com JavaScript habilitado.
O modo headless é opcional e habilita-se com a flag -headless. As opções adicionais de navegador/headless documentadas:
-sc/-system-chrome: usar o Chrome instalado localmente-sb/-show-browser: exibir a janela do navegador durante a execução-ho/-headless-options: passar opções personalizadas ao Chrome-nos/-no-sandbox: desabilitar a sandbox do Chrome (útil para usuários root)-cdd/-chrome-data-dir: definir um diretório de dados do Chrome-scp/-system-chrome-path: apontar o caminho do executável do Chrome-noi/-no-incognito: desabilitar o modo anônimo
Reconhecimento básico de sites
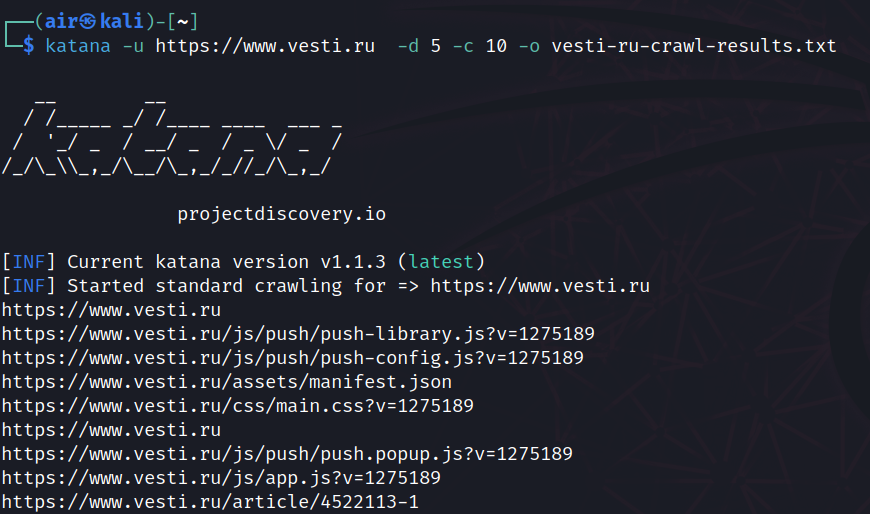
Comecemos por um cenário fundamental de reconhecimento: mapear a estrutura de um site-alvo e descobrir todos os endpoints acessíveis. A demonstração de referência aplicou a varredura básica contra o portal de notícias russo Vesti.ru; o comando genérico da fonte usa um domínio de exemplo:
katana -u https://<ALVO> -d 5 -c 10 -o target-crawl-results.txtCada flag tem função direta:
-u: especifica a URL do alvo-d 5: define a profundidade máxima de crawling em 5 níveis-c 10: usa 10 threads concorrentes para um crawling mais rápido-o: salva todas as URLs descobertas em um arquivo
Na saída da demonstração, o crawl em modo padrão do Vesti.ru devolveu os endpoints da home e arquivos estáticos — push-library.js, push-config.js, manifest.json, main.css — além de URLs de matérias, todas gravadas no arquivo de resultados.
Crawling de aplicações JavaScript-heavy
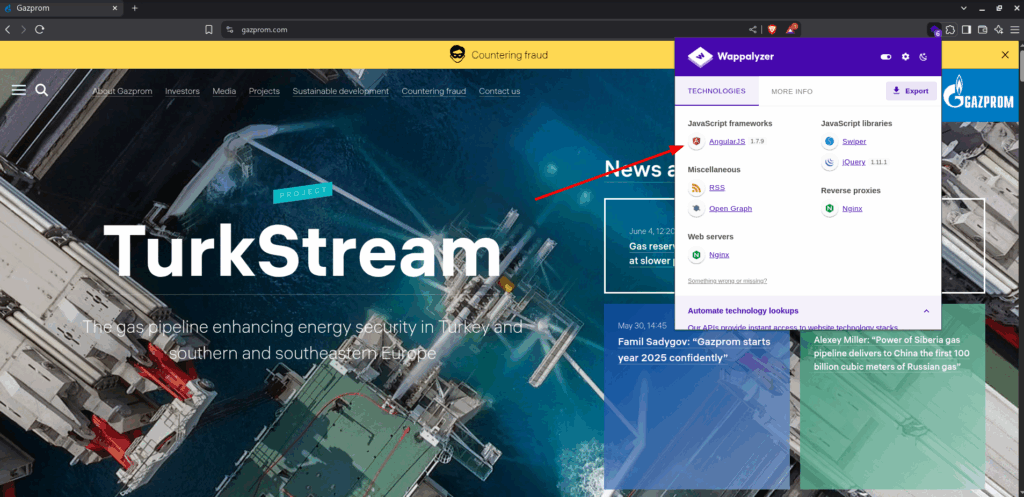
Aplicações web modernas frequentemente dependem de JavaScript para gerar conteúdo — o cenário exato em que crawlers tradicionais falham. A demonstração de referência trabalhou sobre um portal construído em AngularJS.
O alvo: um portal AngularJS
A home do alvo escolhido pela demonstração exibe bibliotecas de scripts embutidas e bindings do framework visíveis no conteúdo renderizado — o tipo de aplicação que exige execução de JavaScript durante o crawling para revelar endpoints.
Varredura headless com -js-crawl
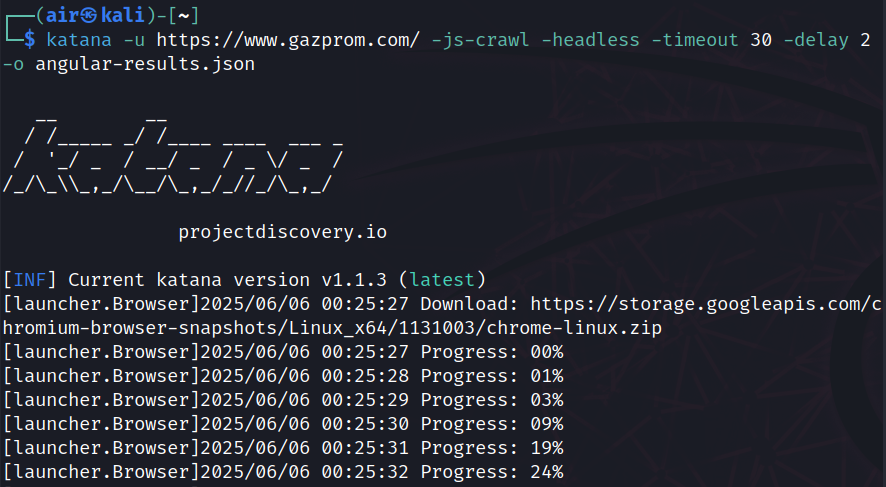
O comando da fonte, com o domínio ilustrativo de aplicação AngularJS:
katana -u https://<APP-ANGULAR> -js-crawl -headless -timeout 30 -delay 2 -o angular-results.jsonFlag a flag, conforme a fonte:
-js-crawl: habilita a execução/análise de JavaScript durante o crawling, para tratar controllers e diretivas AngularJS-headless: usa Chrome headless para renderizar templates AngularJS e executar os ciclos de digest do framework-timeout 30: define 30 segundos de timeout para o carregamento de páginas, acomodando o bootstrapping do AngularJS-delay 2: adiciona 2 segundos de atraso entre requisições, dando tempo às transições de roteamento do AngularJS-o: salva a saída em arquivo
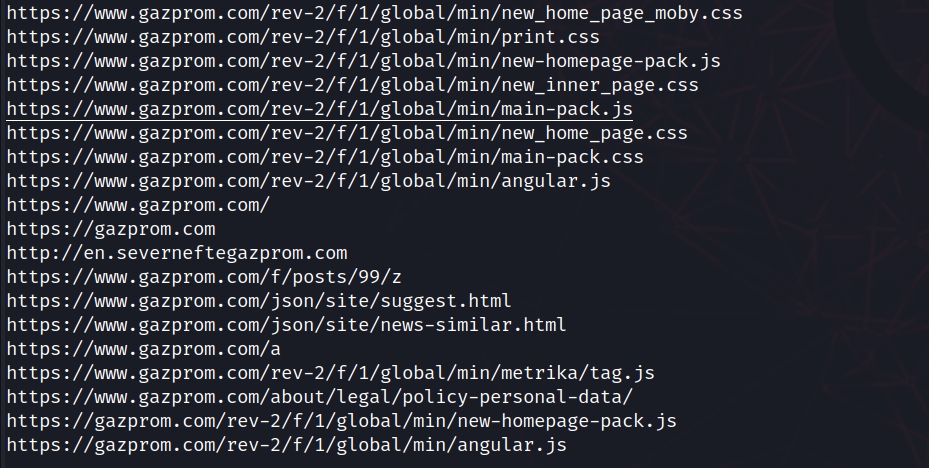
Na execução da demonstração, o primeiro uso do modo headless baixa o navegador gerenciado pelo Katana — o binário Chromium — com barra de progresso antes da varredura. Em seguida, o crawler devolve os recursos do site: new-homepage-pack.js, main-pack.js, angular.js, folhas de estilo por seção e endpoints JSON de sugestão e notícias similares. É o conteúdo gerado por JavaScript que um crawler tradicional não alcançaria.
Descoberta de arquivos conhecidos
Varra arquivos comuns como robots.txt e sitemap.xml, que frequentemente revelam informações valiosas sobre a estrutura do site e conteúdo oculto. Estes arquivos podem fornecer:
- robots.txt: diretórios e arquivos desautorizados que podem conter informações sensíveis
- sitemap.xml: estrutura completa do site, incluindo páginas não ligadas na navegação principal
- Outros arquivos de descoberta: arquivos de configuração, backups e interfaces administrativas comuns
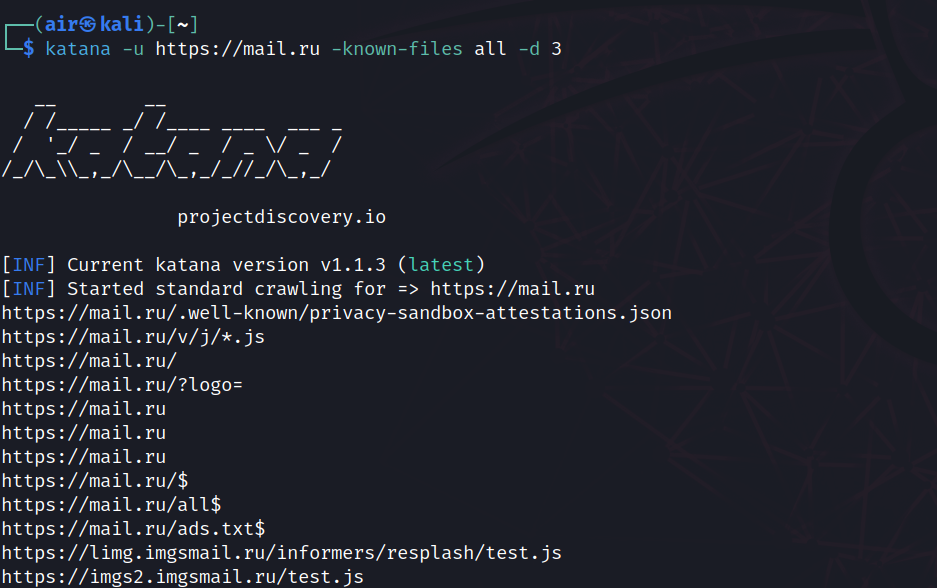
O comando da fonte, com domínio de exemplo:
katana -u https://<ALVO> -known-files all -d 3A demonstração rodou contra o mail.ru: a varredura com -known-files all devolveu ads.txt, arquivo de atestação em .well-known/ (privacy-sandbox-attestations.json) e scripts de teste expostos na infraestrutura de CDN.
Nota importante da documentação oficial: uma profundidade mínima de 3 é exigida para garantir a descoberta completa de todos os arquivos conhecidos na aplicação-alvo.
Capacidades de filtragem
O Katana oferece recursos robustos de filtragem para processar, refinar e gerenciar a saída do crawling com precisão. Essas capacidades facilitam isolar dados valiosos, reduzir ruído e ajustar os resultados aos objetivos específicos — flexibilidade crucial para lidar com o grande volume de dados que um crawl produz.
É possível filtrar a saída por campos específicos, incluir ou excluir URLs por extensões ou expressões regulares, e até definir campos personalizados via arquivo de configuração YAML. As principais opções:
-field/-f: exibir campos específicos na saída (por exemplourl,path,fqdn,rdn)-store-field/-sf: salvar os campos selecionados em disco-extension-match/-em: exibir apenas URLs com determinadas extensões-extension-filter/-ef: excluir URLs com determinadas extensões-match-regex/-mr: incluir URLs que casam com um padrão regex-filter-regex/-fr: excluir URLs que casam com um padrão regex
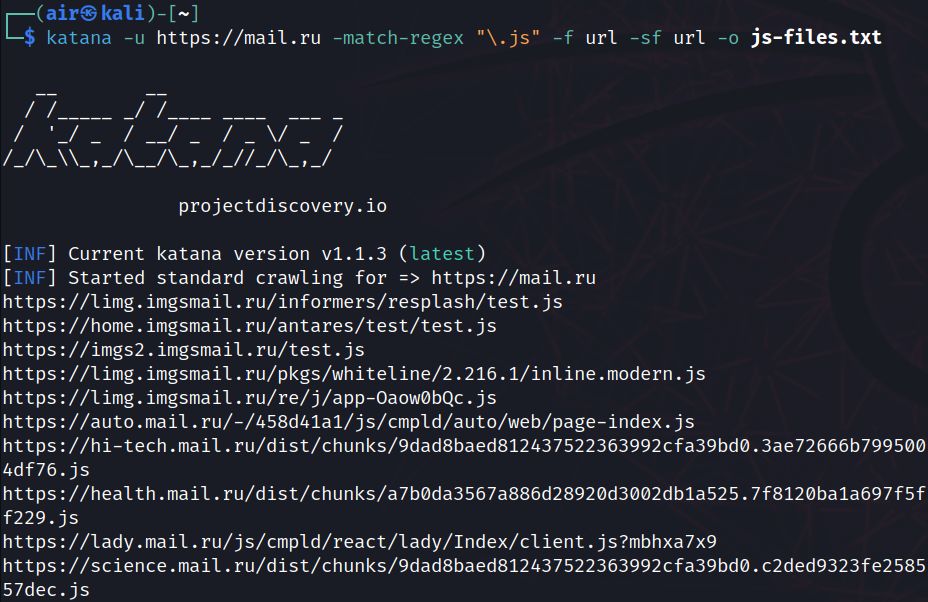
Exemplo da fonte: para extrair apenas URLs .js — inclusive as com parâmetros de query — e salvar as URLs completas em arquivo:
katana -u https://<ALVO> -match-regex "\.js" -f url -sf url -o js-files.txtNa demonstração, o filtro aplicado ao mail.ru isolou os arquivos JavaScript de toda a árvore do crawl: scripts de resplash, chunks de build com hash no nome (9dad8baed812437522363992cfa39bd0 + 3ae72666b7995004df76.js), bundles modern.js e page-index.js — todos gravados em js-files.txt.
Perspectiva defensiva
Do lado de quem defende, o Katana é a mesma ferramenta com o objetivo invertido: descobrir o que está exposto antes que um adversário encontre. Rodar katana -u https://<SEU-DOMINIO> contra o próprio site mapeia a superfície que um atacante vê: endpoints órfãos, arquivos de backup, diretórios listáveis e scripts esquecidos.
Três frentes defensivas se destacam dos recursos mapeados neste artigo:
- robots.txt como mapa de ataque: o arquivo lista justamente o que se quer esconder. Se ele referencia diretórios sensíveis, esses caminhos devem exigir autenticação real, não apenas confiar na exclusão do índice.
- Scripts de terceiros e CDNs: o crawl da demonstração expôs scripts de teste e chunks de build em CDNs. Todo arquivo JavaScript publicamente acessível é código que um adversário audita em busca de segredos, chaves e endpoints internos.
- Sitemap e arquivos conhecidos: sitemap.xml entrega a estrutura completa, incluindo páginas fora da navegação principal. Se ele existe e é público, tudo nele precisa ser tratado como público.
Em CI/CD, o Katana entra como gate de superfície: um crawl periódico no ambiente de staging com diff contra a baseline revela endpoints novos antes do deploy.
Limitações
Este artigo é documental: descreve a ferramenta, seus comandos e os resultados conforme a documentação oficial e o material de referência, sem execução própria nesta ocasião. Os resultados citados são os da demonstração de referência, não testes independentes.
Quanto à ferramenta: a instalação via go install exige uma versão atual de Go — o README oficial registra o requisito de Go 1.26+ no momento desta redação (a demonstração usou Go 1.24.2, ainda compatível naquela ocasião) e recomenda tentar com a versão mais recente diante de falhas de instalação. O Headless Mode exige o download do navegador gerenciado no primeiro uso e adiciona sobrecarga de browser ao crawl, sendo mais lento que o modo padrão. A documentação também registra que a opção -store-response não é suportada em modo headless. Os domínios usados nos exemplos da fonte são ilustrativos; os resultados citados referem-se aos alvos reais demonstrados.
Considerações éticas
O Katana é uma ferramenta de reconhecimento — na prática, faz requisições HTTP contra um alvo e segue links, como um navegador faria. Ainda assim, crawling automatizado sem autorização gera tráfego mensurável e pode violar termos de uso. O padrão de uso correto é o mesmo da demonstração: alvos autorizados — pentest contratado, bug bounty dentro do escopo, ou o próprio ambiente.
O README oficial é categórico ao lembrar que a responsabilidade é de quem executa: use com cautela, você é responsável por suas ações. Em bug bounty, respeite rate limits do programa; as flags de atraso e concorrência (-delay, -c) servem exatamente para dosar o impacto contra o alvo.
Conclusão
Seja em pentests, pesquisas de bug bounty ou operações de cyberwar abrangentes, as capacidades avançadas e a arquitetura moderna do Katana o tornam um acréscimo essencial ao kit de ferramentas de segurança ofensiva.
O percurso deste artigo resume o valor da ferramenta: do crawl padrão de um site tradicional ao headless para single-page applications AngularJS, passando pela descoberta de arquivos conhecidos e pelos filtros de campo, extensão e regex — o Katana cobre o reconhecimento web moderno de ponta a ponta.


